Når du bygger AI-drevne produkter, har du brug for inferens: muligheden for at sende en prompt til en model og få et svar tilbage. Medmindre du kører dine egne GPU'er, køber du den ydelse hos en udbyder.
Når du har valgt en model, kan du ofte vælge, hvor den skal køre. Open source-modeller som MiniMax, gpt-oss eller Mistral leveres af dusinvis af konkurrerende udbydere. Selv proprietære modeller som GPT eller Claude fås gennem flere kanaler end producenternes egne API'er.
Så du filtrerer først på det grundlæggende: GDPR-compliance, datasuverænitet og zero data retention, hvis du har brug for det. Derefter sammenligner du priser. Udbyder A tager €0,27 per million tokens, udbyder B tager €0,77 for præcis den samme model (priser ekskl. moms). Et nemt valg, ikke?
Helt så enkelt er det ikke: Den samme model med bogstavelig talt identiske vægte kan klare sig helt forskelligt hos forskellige udbydere. Prisen per token er nødvendig at kende, men sjældent nok.
Hvad der går galt
Her er en historie, jeg har set udspille sig flere gange. Et team bygger en AI-funktion og skal vælge en udbyder. De sammenligner tokenpriser, ser, at én tager €0,27 per million tokens og en anden €0,77, og vælger den billigste. Det virker som en indlysende beslutning.
Tre måneder senere dukker problemerne op. Brugerne klager over, at AI'en "føles langsom". Agentiske workflows, der burde være færdige på 2 minutter, tager 15. Lange dokumenter giver timeouts. I spidsbelastningsperioder bliver kvaliteten uforudsigelig.
Så skifter teamet udbyder efter at have spildt måneders integrationsarbejde og frustreret brugerne undervejs.
Udbyderen var ikke problemet. Problemet var måden, teamet vurderede den på.
Hvorfor prisen per token er misvisende
Se på reelle benchmarkdata for DeepSeek V3.2 hos fire udbydere:
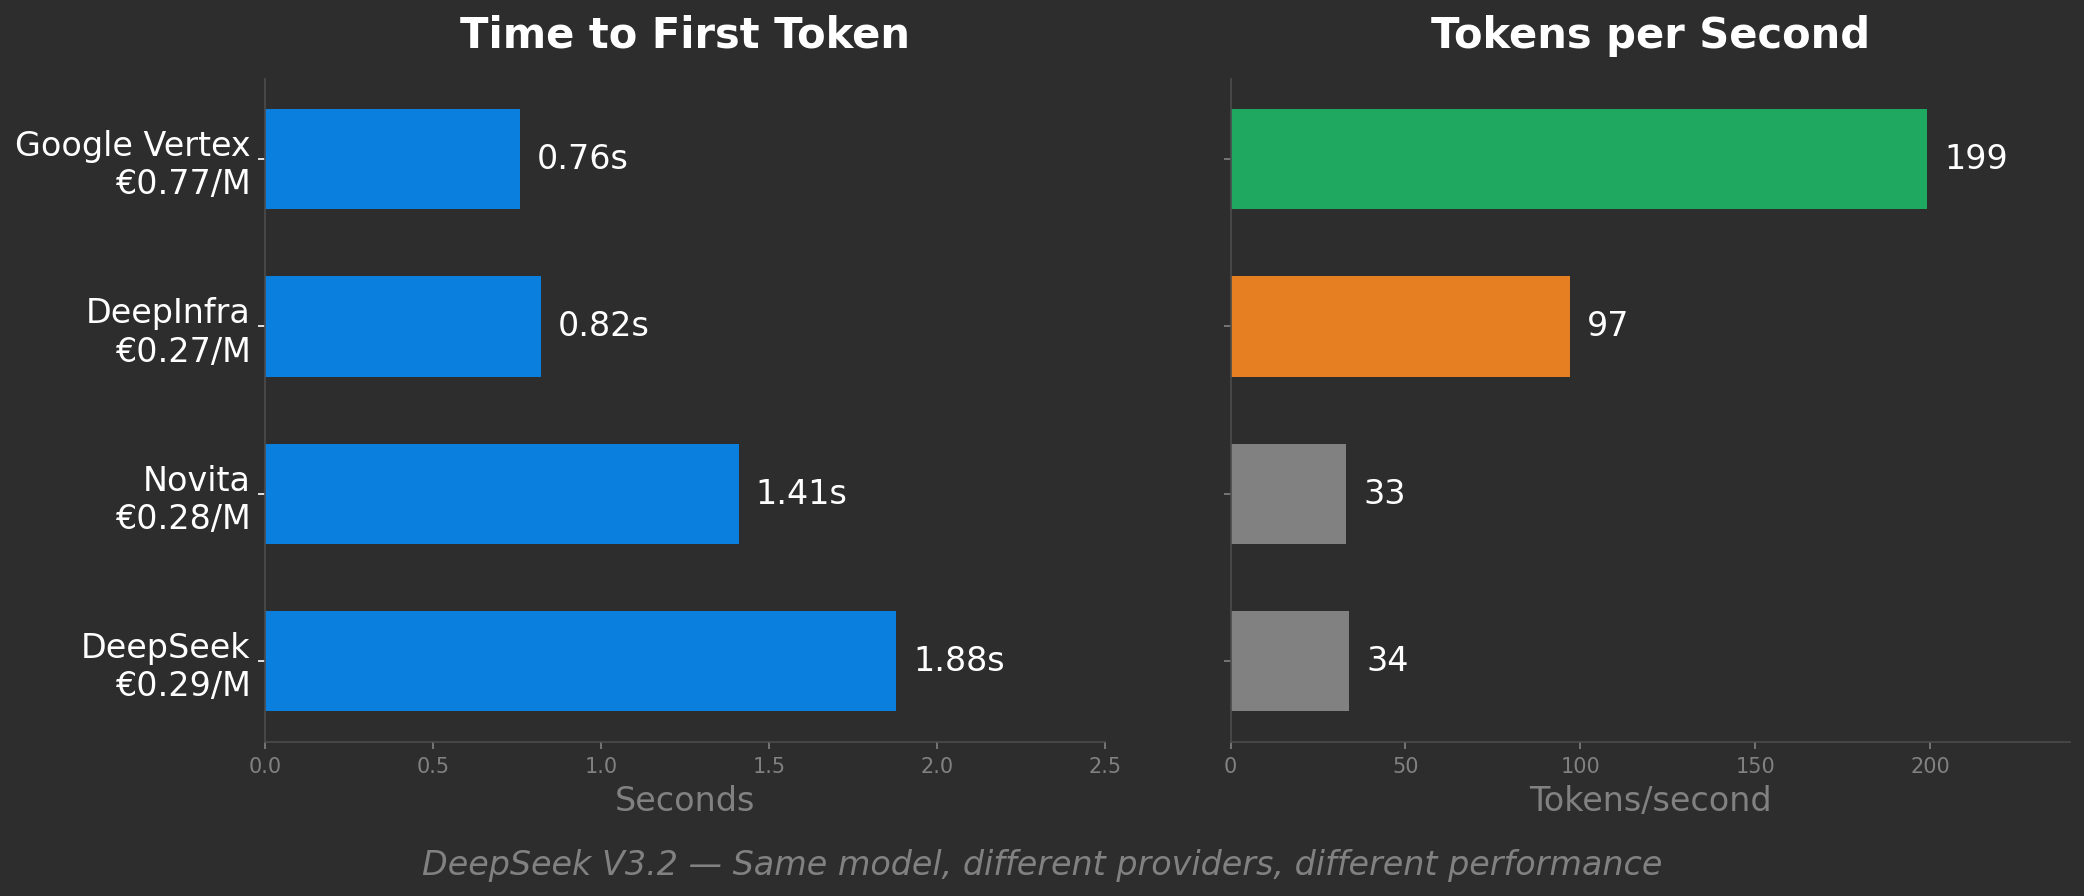
DeepInfra ligner det kloge valg: halvt så hurtig som Google Vertex, men til en tredjedel af prisen. Novita og DeepSeeks egen API er lige så billige, men 6x langsommere end Vertex.
Men "prisen per token" fortæller dig intet af dette. Den behandler alle fire som ens produkter, og det er de ikke.
Det, der betyder noget: fem faktorer
Når du sender en prompt til en inferens-API, overtager udbyderens infrastruktur. Din forespørgsel havner i en kø og sendes videre til hardwaren, modellen behandler dit input, og tokens begynder at strømme tilbage. Fem ting afgør, hvordan den proces fungerer, og om udbyderen passer til dit use case:
Time to First Token (TTFT): Hvor lang tid går der, før outputtet begynder at dukke op? Brugerne skal kunne se, at der sker noget. En TTFT på 200ms føles responsiv. En tom skærm i 2 sekunder føles, som om noget er i stykker, selv om den samlede svartid ender med at være den samme. Husk, at TTFT inkluderer netværkslatens: Når en bruger i EU kalder en udbyder i USA, kommer der 100-150ms oveni, før inferensen overhovedet begynder. Og gennemsnit lyver: Produktionssystemer går i stykker på p95/p99-latens, ikke på medianer.
Tokens per sekund: Hvor hurtigt strømmer tokens efter det første? Det afgør, hvornår du har det komplette svar. I en chat-brugerflade læser brugerne med, mens svaret strømmer ind, så tokens per sekund betyder mindre. For et agentisk workflow, der venter på det fulde svar før næste trin, er tokens per sekund alt. Også her betyder fordelingen noget: Stabile 80 tok/s er bedre end svingende 50-150 tok/s.
Hvis du har arbejdet med web-performance (Core Web Vitals, Lighthouse-scores), kender du forskellen på, hvornår noget vises, og hvornår det kan bruges. TTFT svarer til First Contentful Paint, og tokens per sekund svarer til Time to Interactive.
Kapacitet: Kan udbyderen håndtere din volumen? Det handler om rate limits, grænser for samtidige forespørgsler, og om ydeevnen falder under belastning. En udbyder kan være hurtig i dit proof of concept og alligevel drosle dig i produktion.
Konteksthåndtering: Holder ydeevnen med lange input? En prompt på 4K og en på 64K tokens koster det samme per token, men de koster udbyderen meget forskellige beløb at levere. Nogle udbydere bliver markant langsommere, andre drosler, og andre igen tager sig bedre betalt.
Kvalitet: Får du fuld præcision, eller kører udbyderen i stilhed en komprimeret version af modellen for at spare hukommelse? Lavere præcision kan give lidt dårligere output, især ved svær ræsonnering eller opgaver med lang kontekst.
Alle udbydere laver afvejninger mellem de fem faktorer og prisen. Optimerer man én, koster det ofte på en anden. Spørgsmålet er: Hvilke afvejninger passer til min workload?
Forskellige workloads, forskellige prioriteter
De rigtige afvejninger afhænger helt af, hvad du bygger. En chatbot og en batch-pipeline har modsatte prioriteter. Det, der hjælper den ene, skader den anden.
Her er en grov oversigt over, hvordan de fem faktorer typisk vægter. Dit use case kan afvige (en chatbot med meget lange samtaler har mere brug for god konteksthåndtering end en typisk chatbot), men oversigten giver dig et udgangspunkt:
| Workload | TTFT | Tokens/s | Kapacitet | Kontekst | Kvalitet |
|---|---|---|---|---|---|
| Interaktiv chat | ●●● | ● | ●● | ● | ●●● |
| Batchbehandling | ● | ● | ●●● | ● | ●● |
| Agentiske workflows | ● | ●●● | ●● | ●●● | ●●● |
| Voice AI / realtid | ●●● | ●●● | ●● | ● | ●●● |
| RAG / retrieval | ●● | ● | ● | ●●● | ●●● |
●●● = kritisk, ●● = vigtigt, ● = mindre vigtigt
Eksempel: agentiske workflows. En agent, der foretager 50 inferenskald for at løse en opgave, er ikke særlig optaget af TTFT, for intet menneske følger med mellem trinene. Til gengæld hober tokens per sekund sig op: Hvis hvert kald genererer 500 tokens, tager det 5 sekunder ved 100 tok/s og 17 sekunder ved 30 tok/s. Over 50 kald bliver det 4 minutter mod 14 minutter for den samme opgave. Konteksthåndtering betyder også noget: Agentens samtaler vokser, mens den arbejder, og udbydere, der bliver langsommere fra 32K tokens, bliver en flaskehals for dit workflow.
Når du kender din workload, kan du vurdere udbydere ordentligt. Men først skal du forstå, hvorfor afvejningerne findes.
Hvorfor afvejningerne findes
De fleste inferensudbydere kører på GPU'er, så afvejningerne nedenfor gælder GPU-baseret infrastruktur. Alternative arkitekturer som Googles TPU'er eller SambaNovas dataflow-chips håndterer nogle af dem anderledes, men GPU'er er stadig branchens udgangspunkt.
Prefill vs. decode: to forskellige problemer
Når du sender en forespørgsel til en LLM, sker der to adskilte faser:
Prefill (behandling af dit input): Modellen læser hele din prompt og finder ud af, hvordan hvert ord hænger sammen med alle de andre (det kaldes "attention"). Den behandler alle input-tokens på én gang, parallelt. GPU'er er fremragende til den slags parallelt arbejde og kører med høj udnyttelse.
Decode (generering af output): Nu producerer modellen output-tokens ét ad gangen. Vægtene ligger i GPU'ens hukommelse, men for hvert token skal GPU'en læse dem igennem for at beregne næste forudsigelse. Flaskehalsen er hukommelsesbåndbredden, ikke regnekraften. GPU'erne står stille og venter på data, og udnyttelsen falder markant.
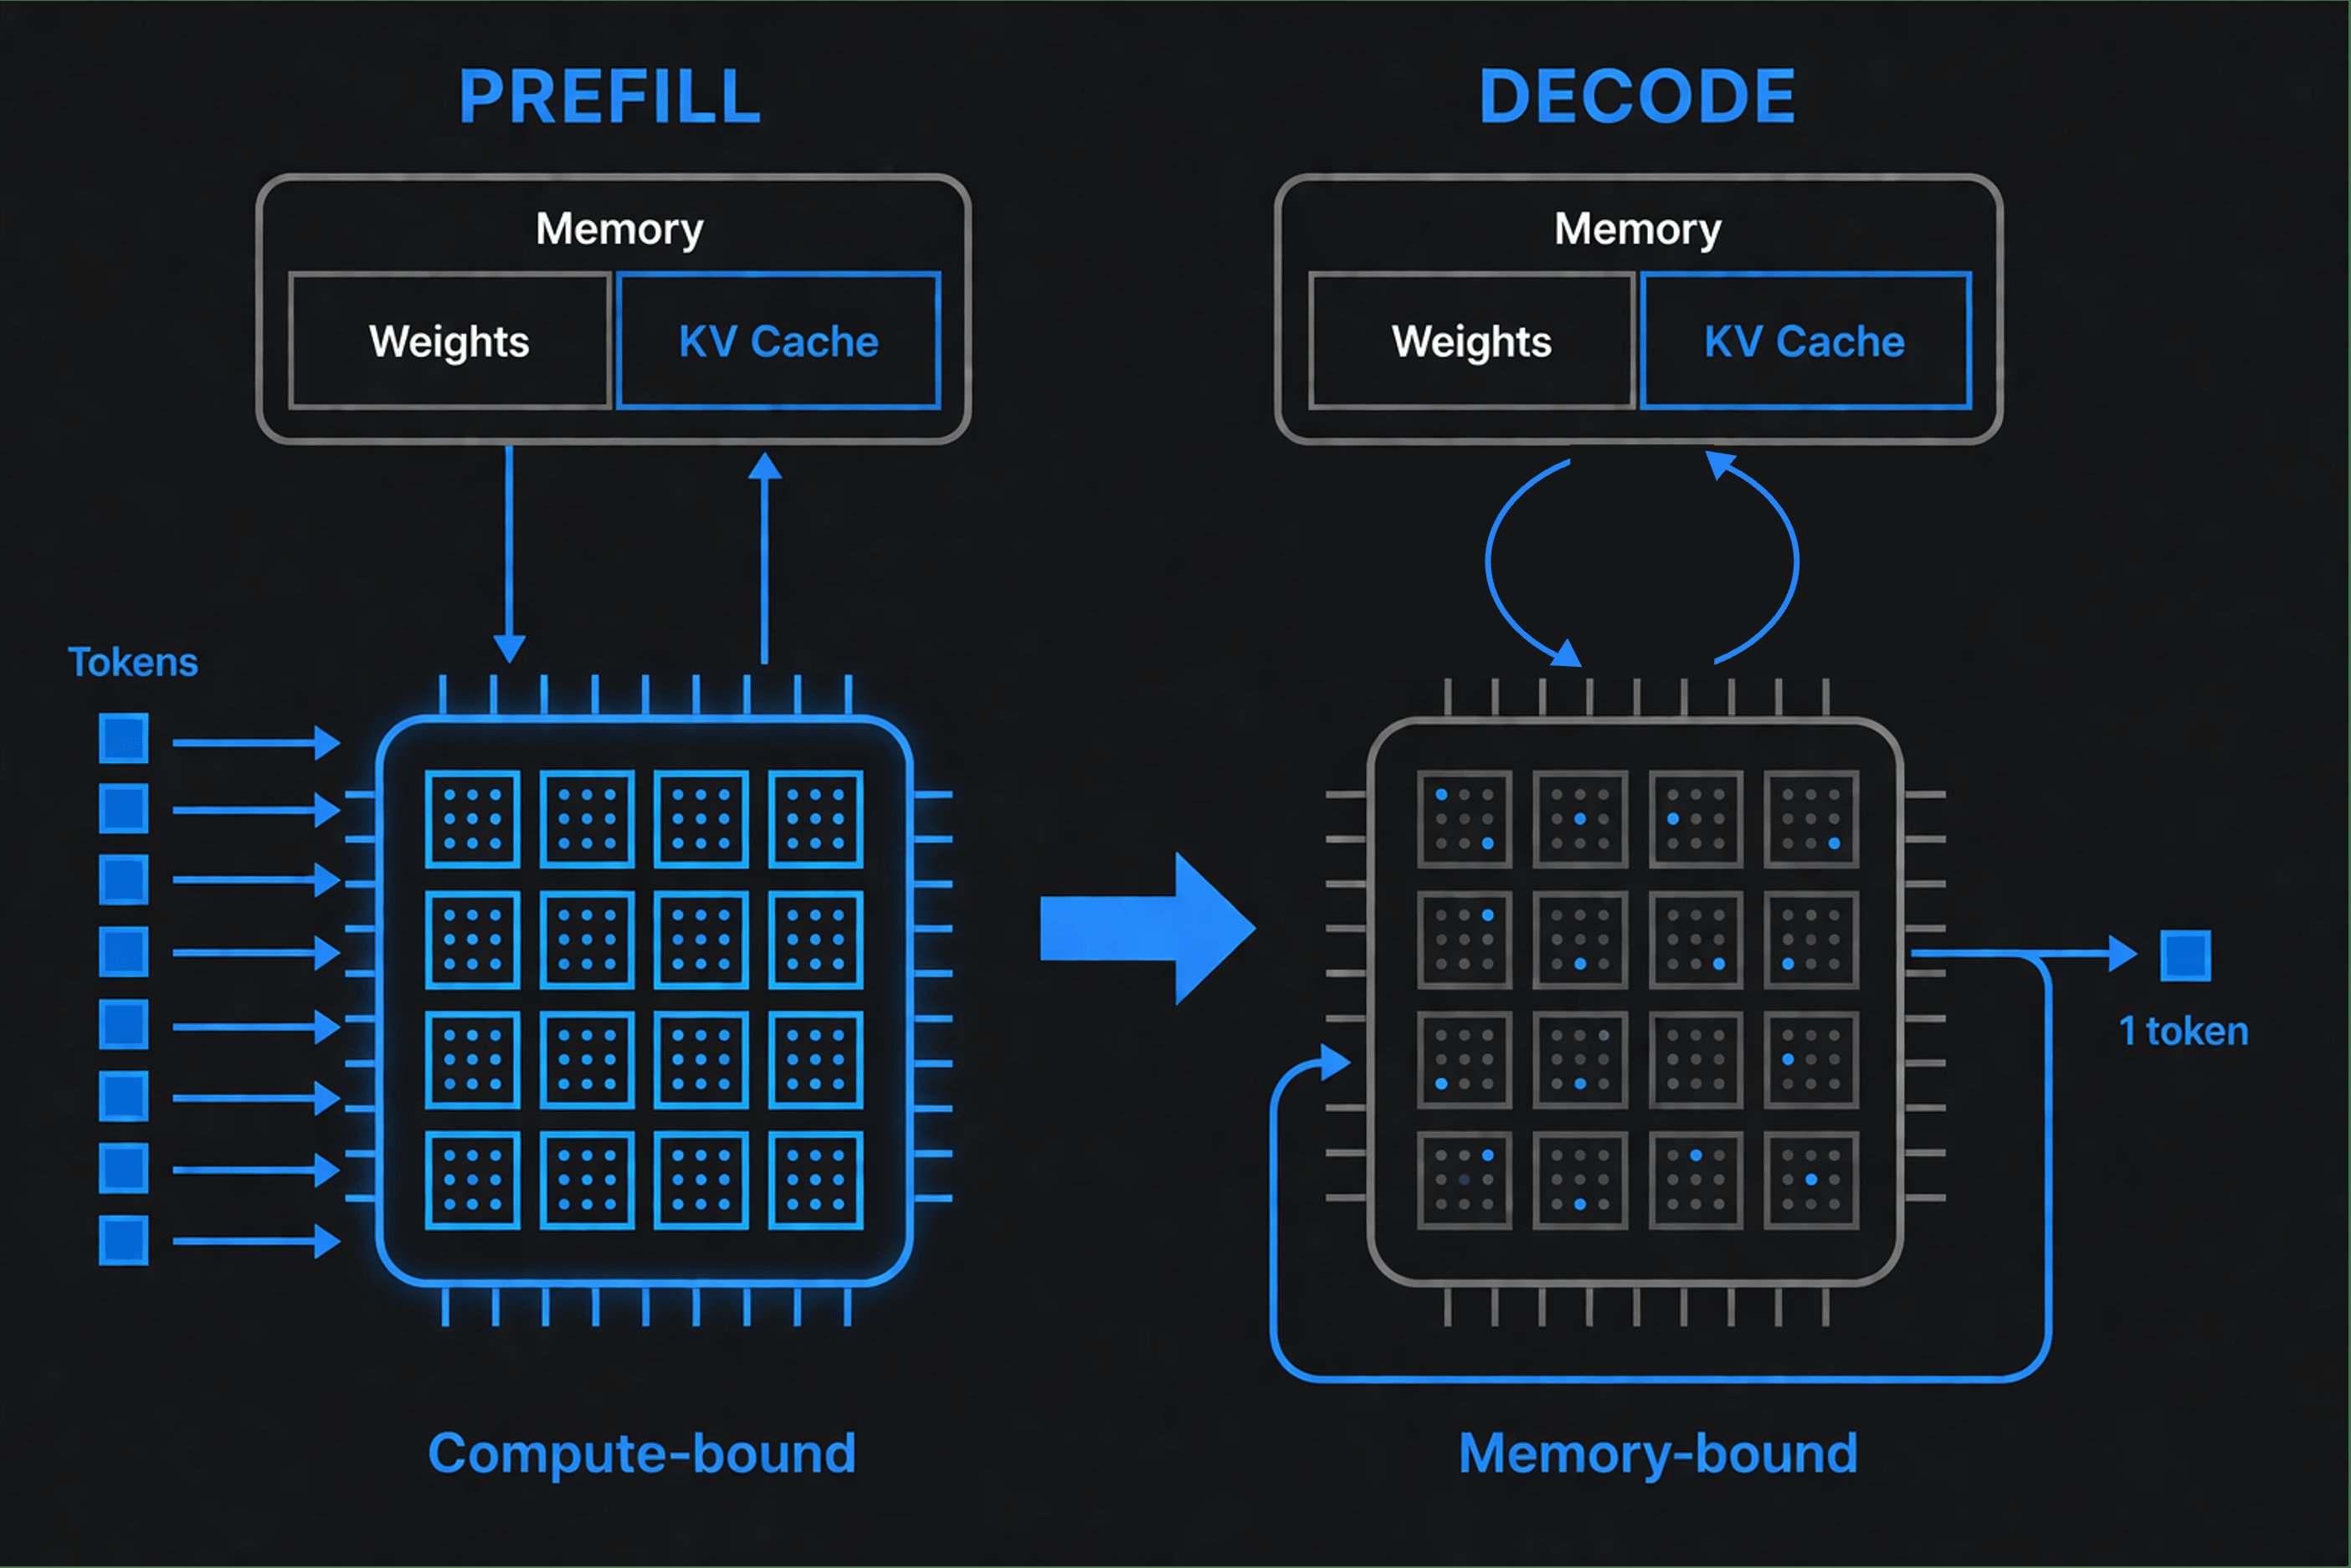
Det giver to separate målinger:
- Time to First Token (TTFT): Hvor lang tid der går, før outputtet starter, afgøres af prefill.
- Tokens per sekund: Hvor hurtigt tokens derefter strømmer til dig, afgøres af decode.
En udbyder, der er optimeret til prefill, viser hurtig TTFT, men kan have langsom decode. En, der er optimeret til decode, streamer hurtigt, men er længere om at starte. Ingen af dem er "bedre", for det afhænger af din workload.
Kontekstlængde: den skjulte omkostningsmultiplikator
De fleste udbydere tager den samme pris per token uanset kontekstlængde. Men beregningsomkostningen er ikke konstant.
Prefill vokser kvadratisk med standard-attention i transformere. Modellen beregner, hvordan hvert ord hænger sammen med alle de andre. En prompt på 1.000 tokens betyder 1 million beregninger af den slags, en prompt på 10.000 tokens 100 millioner. Fordobler du konteksten, bliver attention-beregningen cirka firedoblet. (Moderne optimeringer som FlashAttention mindsker det i praksis, men presset fra skaleringen består.)
Reelle tal fra Metas drift af Llama 3 405B:
- 128K tokens: 3,8 sekunders prefill
- 1M tokens: 77 sekunders prefill
Decode bliver også langsommere med konteksten. Under genereringen gemmer modellen mellemresultater i en "KV-cache", en slags kladdeblok over samtalen indtil nu. Cachen vokser lineært med konteksten. En samtale på 128K tokens kræver omkring 40 GB alene til cachen på en 70B-model.
For hvert nyt token læser modellen hele cachen. En større cache bruger mere hukommelsesbåndbredde, og tokens per sekund falder. Og da hukommelsen deles mellem brugere, betyder større caches færre samtidige brugere.
Hvordan håndterer udbyderne det? På tre måder:
- Krydssubsidiering: Brugere med kort kontekst betaler for brugere med lang kontekst
- Trinvise priser: Google tager 2x for kontekst over 200K tokens
- Dårligere service: Forespørgsler med lang kontekst bliver droslet eller nedprioriteret
Hvis din workload er kontekst-tung, betyder det noget. Hvis du bruger korte prompts, subsidierer du måske andre.
Batching: Sådan bytter udbydere dine tokens/s for deres kapacitet
Hvad er batching? I stedet for at behandle én forespørgsel ad gangen samler udbyderne flere forespørgsler og behandler dem samtidig. Det udnytter GPU'en bedre, ligesom en bus med 50 passagerer frem for 50 taxaer.
Ved en batchstørrelse på 1 er GPU'erne dårligt udnyttet, fordi de venter på hukommelsen. Ved en batchstørrelse på 128 indlæser de modelvægtene én gang og behandler alle 128 forespørgsler sammen. Udbyderen kan betjene langt flere brugere, og kapaciteten stiger.
Hagen er, at dine tokens per sekund falder. En model, der leverer 400 tok/s til en enkelt bruger, leverer måske 30-50 tok/s per bruger, når den kører i batch med 127 andre. Alle venter på alle. (Moderne systemer bruger continuous batching til at mindske denne afvejning, men det fjerner den ikke.)
For batch-workloads er det fint. Her vil du have, at udbyderen maksimerer kapaciteten, og tokens per sekund for den enkelte forespørgsel er ligegyldige.
For interaktive workloads er det slemt. Dine brugere er ligeglade med, at systemet behandlede 10.000 forespørgsler i det sekund. De bekymrer sig om, at deres svar tog 3 sekunder.
Når en udbyder oplyser "forespørgsler per sekund" eller "tokens per sekund", så spørg: Er det systemets samlede kapacitet, eller de tokens per sekund, hver bruger oplever? Det er meget forskellige tal.
Kvantisering: den præcision, ingen fortæller dig om
Hvad er kvantisering? AI-modeller gemmer viden som milliarder af tal ("vægte"). De kan gemmes med forskellig præcision, lidt som at måle i millimeter eller centimeter. Lavere præcision sparer hukommelse, men kan gøre outputtet dårligere.
| Præcision | Hukommelsesbesparelse | Kvalitetseffekt |
|---|---|---|
| FP16/BF16 | Baseline | Ingen (de fleste modeller trænes i dette format) |
| FP8 | ~50% | Minimal (<1% tab af nøjagtighed) |
| INT8 | ~50% | Lille (99%+ af nøjagtigheden bevares) |
| INT4 | ~75% | Mærkbar på krævende opgaver |
FP8 og INT8 er næsten usynlige for de fleste workloads. Med INT4 kan der opstå problemer: Forskning viser i værste fald op til 59% tab af nøjagtighed på opgaver med lang kontekst og 69,8% forringelse ved svær ræsonnering. Effekten varierer meget fra opgave til opgave. Mange praktiske anvendelser oplever langt mindre fald, men ræsonnering over lang kontekst er særligt følsom.
De fleste udbydere oplyser ikke deres kvantiseringsniveau. Nogle justerer præcisionen dynamisk efter belastningen: fuld præcision kl. 2 om natten, kvantiseret i spidsbelastningstimerne. Prisen er den samme, men produktet er et andet.
For batchbehandling kan aggressiv kvantisering være acceptabel. Her optimerer du på omkostninger, og små tab af nøjagtighed kan tåles.
For produktionsapplikationer skal du vide, hvilken præcision du får.
Hvorfor output-tokens koster mere
De fleste udbydere tager 4-6x mere for output-tokens end for input-tokens:
| Udbyder | Input €/M | Output €/M | Forhold |
|---|---|---|---|
| OpenAI GPT-5.4 | €2.30 | €13.80 | 6x |
| Anthropic Claude Opus 4.6 | €4.60 | €23.00 | 5x |
| Google Gemini 3.1 Pro | €1.84 | €11.00 | 6x |
| DeepSeek V3.2 | €0.13 | €0.26 | 2x |
Kilde, omregnet til ~€0,92/$
Hvorfor? Husk forskellen på prefill og decode: Behandlingen af input holder GPU'en beskæftiget, genereringen af output gør ikke. Multiplikatoren afspejler groft sagt forskellen i GPU-effektivitet mellem de to.
Læg mærke til DeepSeek med 2x. DeepSeek kombinerer MoE (671B parametre, hvoraf kun 37B er aktive) med sparse attention, der mindsker beregningen ved lang kontekst. V4, der kom i april 2026, går endnu længere. Arkitekturen ændrer økonomien.
Input-tunge workloads (RAG, lange prompts, korte svar) har fordel af den opdeling. Output-tunge workloads (kodegenerering, indholdsproduktion) bliver ramt af multiplikatoren på 4-6x.
Sådan vurderer du udbydere til din workload
Med den viden kan du stille de rigtige spørgsmål.
Læs videre
For interaktive, brugervendte workloads:
"Hvad er jeres TTFT ved p50 og p99 ved min kontekstlængde?"
Benchmarks uden belastning siger ikke meget. Bed om tal under belastning.
Advarselstegn: Udbyderen har kun syntetiske benchmarks.
"Hvor mange tokens per sekund får hver enkelt bruger?"
Det handler om de tokens per sekund, der strømmer til hver bruger, ikke systemets samlede kapacitet.
Advarselstegn: Udbyderen oplyser "op til"-tal eller målinger for hele systemet.
For batchbehandling:
"Hvad er jeres maksimale vedvarende kapacitet?"
Det handler om det samlede antal tokens i timen, du kan få igennem.
Advarselstegn: Udbyderen kan ikke skelne mellem kapacitetsmålinger og hastighed per bruger.
"Hvilken præcision kører I med ved høj volumen?"
INT4 i stor skala kan sagtens være fint til dit use case.
Advarselstegn: Udbyderen vil ikke oplyse sit kvantiseringsniveau.
For agentiske workloads og lang kontekst:
"Hvor mange tokens per sekund leverer I ved 32K, 64K og 128K kontekst?"
Agentiske workflows venter på komplette svar. Derfor er tokens per sekund ved lang kontekst afgørende.
Advarselstegn: Udbyderen oplyser kun TTFT eller har ingen opdeling efter kontekstlængde.
"Hvor meget falder ydeevnen ved samtidige forespørgsler med lang kontekst?"
Lang kontekst optager hukommelse, der ellers kunne betjene andre brugere. Hvad sker der i stor skala?
Advarselstegn: Udbyderen forstår ikke, hvad du spørger om.
For voice og realtid:
"Hvad er jeres end-to-end-latens for speech-to-text → LLM → text-to-speech?"
Under 500ms, ellers er det ikke realtid.
Advarselstegn: Udbyderen oplyser kun LLM-latensen, ikke hele pipelinen.
Hvorfor det betyder noget nu
Tiden med AI til fast pris og fri afbenyttelse er ved at være forbi.
GitHub har for nylig lagt Copilot om til forbrugsbaseret afregning. Anthropic strammer grænserne for Claude-abonnementer, fordi det agentiske forbrug overstiger det, faste abonnementer var bygget til. Ændringerne på applikationsniveau afspejler virkeligheden nedenunder: Inferens koster penge, og jo flere tokens du bruger, jo dyrere er det at betjene dig. Når de subsidier, der finansierede ubegrænsede abonnementer, forsvinder, bliver det vigtigere at forstå, hvad du reelt køber på inferensniveau.
Nogle udbydere gør det nu eksplicit, for eksempel med Googles Flex- og Priority-niveauer og Amazon Bedrocks trinvise priser, og anerkender dermed, at hastighed i sig selv har en værdi. Afvejningerne skærpes med større modeller: Modeller med billioner af parametre kan ikke være på en enkelt GPU og kræver kompleks parallelisering, hvilket gør hurtig inferens endnu sværere at levere.
De udbydere, der kun konkurrerer på pris, vil skære hjørner, du ikke kan se: kvantisering, batching, drosling. De udbydere, der konkurrerer på de målinger, der betyder noget for din workload, tager sig bedre betalt, og de er pengene værd.
Hold op med at sammenligne prisen per million tokens. Start med de fem faktorer, og find de afvejninger, der passer til din workload.
Infercom offentliggør benchmarks i realtid på infercom.ai/performance, hvis du selv vil sammenligne disse målinger.
Kilder
Benchmarks og ydeevne
- DeepInfra: DeepSeek V3.2 API Benchmarks
- MLCommons MLPerf Inference v5.0
- Artificial Analysis LLM Leaderboard
Arkitektur og beregning
- Meta Engineering: Scaling LLM Inference
- Prefill Is Compute-Bound, Decode Is Memory-Bound
- NVIDIA: KV Cache Offloading
- Transformer FLOPs Analysis
Kvantisering
- Red Hat: vLLM FP8 Benchmarks
- Red Hat: Half Million Evaluations on Quantized LLMs
- EMNLP 2025: INT4 Long-Context Degradation
- COLM 2025: Quantization Impact on Reasoning
Priser og økonomi
Serving og batching
Skrevet af Thomas Vits, med assistance fra AI.