Insights
Tekniske deep dives, brancheanalyser og perspektiver på AI-inferens fra Infercom-teamet.
Determinisme er det forkerte mål: en praktisk guide til pålidelige LLM-resultater
Temperature, top_p, top_k og repetition_penalty forklaret: hvorfor netop temperature=0 truer konsistensen, hvorfor batch-størrelsen ændrer dit output, og hvordan du får pålidelige LLM-resultater.

Open-weight AI-modeller: Hvorfor de er en strategisk fordel
Open-weight-modeller som Gemma og MiniMax driver dine AI-applikationer - og de giver dig friheder, som proprietære API'er ikke kan. Hvad open weight betyder, hvorfor det reducerer leverandørbinding, og hvordan det holder dig i kontrol over dine data.
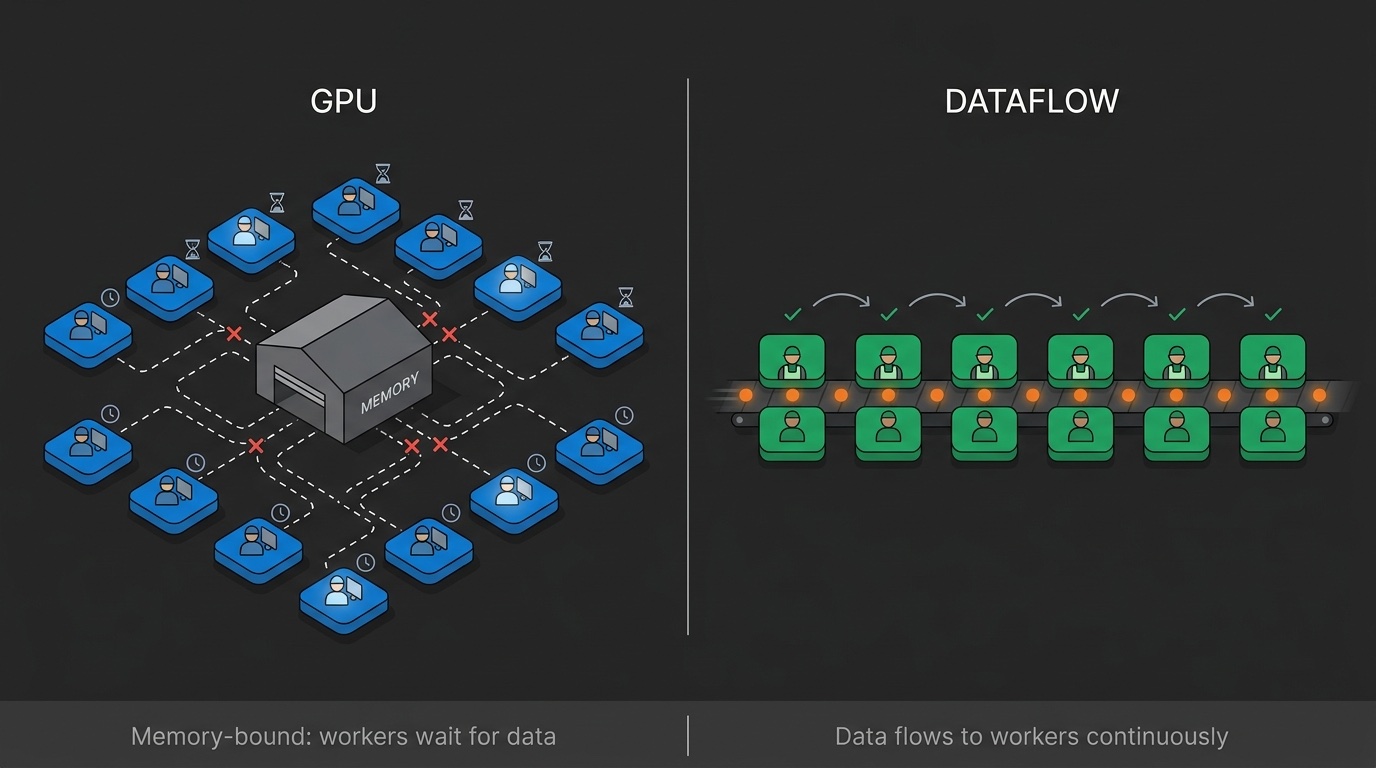
713 tokens i sekundet: arkitekturen bag Ultraspeed
Hvorfor dataflow-arkitektur overgår GPU'er til LLM-inferens. Teknisk forklaring af hukommelses-flaskehalse, rumlig eksekvering og decode-problemet.
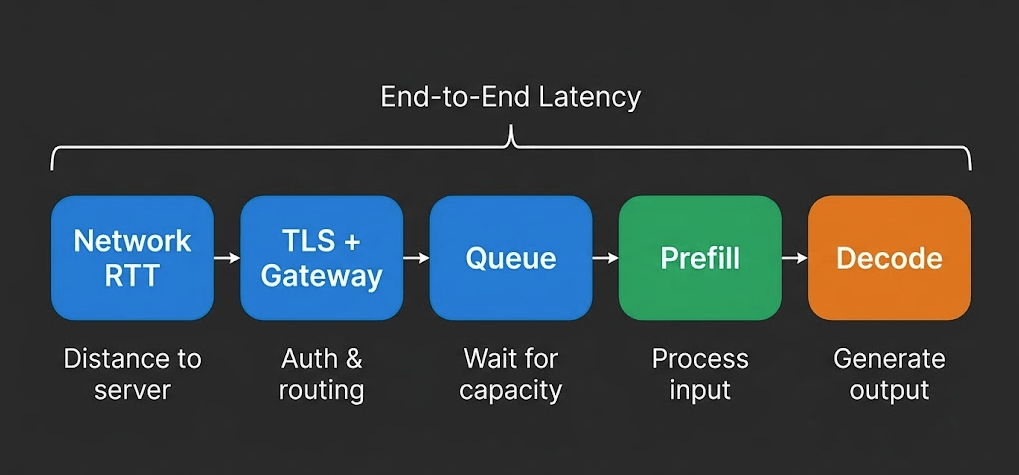
LLM Inference-hastighed forklaret: TTFT, gennemstrømning og hvad der virkelig betyder noget
Når én udbyder reklamerer med 400 tok/s og en anden hævder under 200ms latenstid, måler de forskellige ting. Lær hvilke metrikker der betyder noget for din workload.
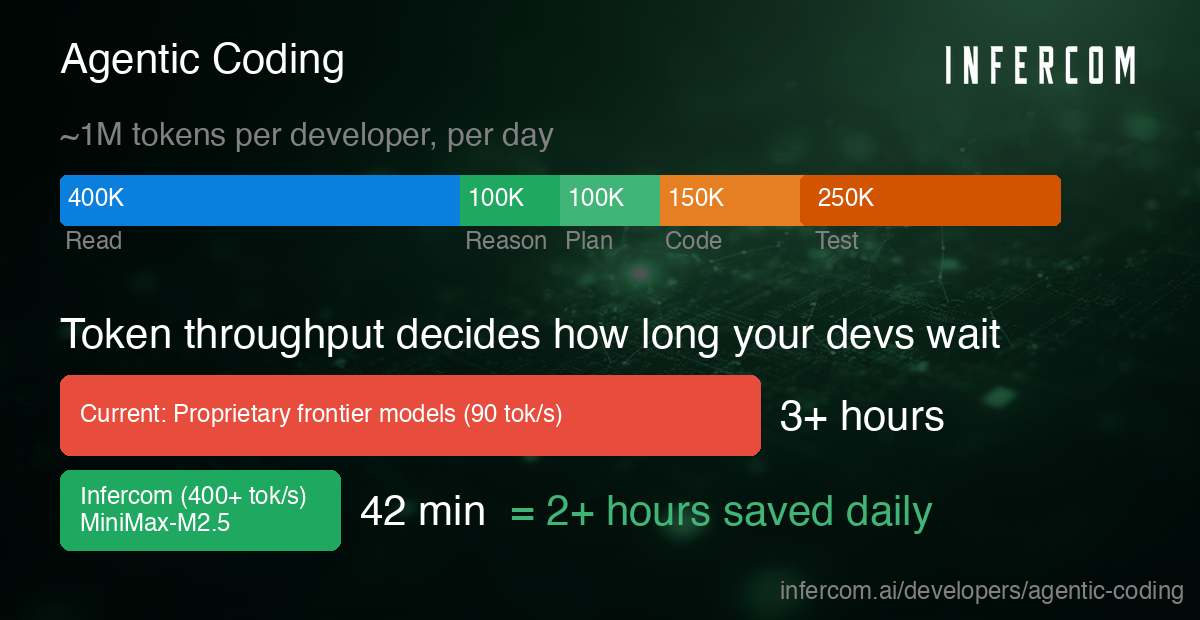
Inferenshastighed i Agentic Coding: Hvorfor Token-gennemstrømning er vigtig
Agentic coding værktøjer forbruger 500K-2M tokens per udvikler om dagen. Denne artikel forklarer, hvorfor inferenshastighed er vigtig, og hvordan man konfigurerer værktøjer som Cursor, Cline og Codex CLI for højere gennemstrømning.
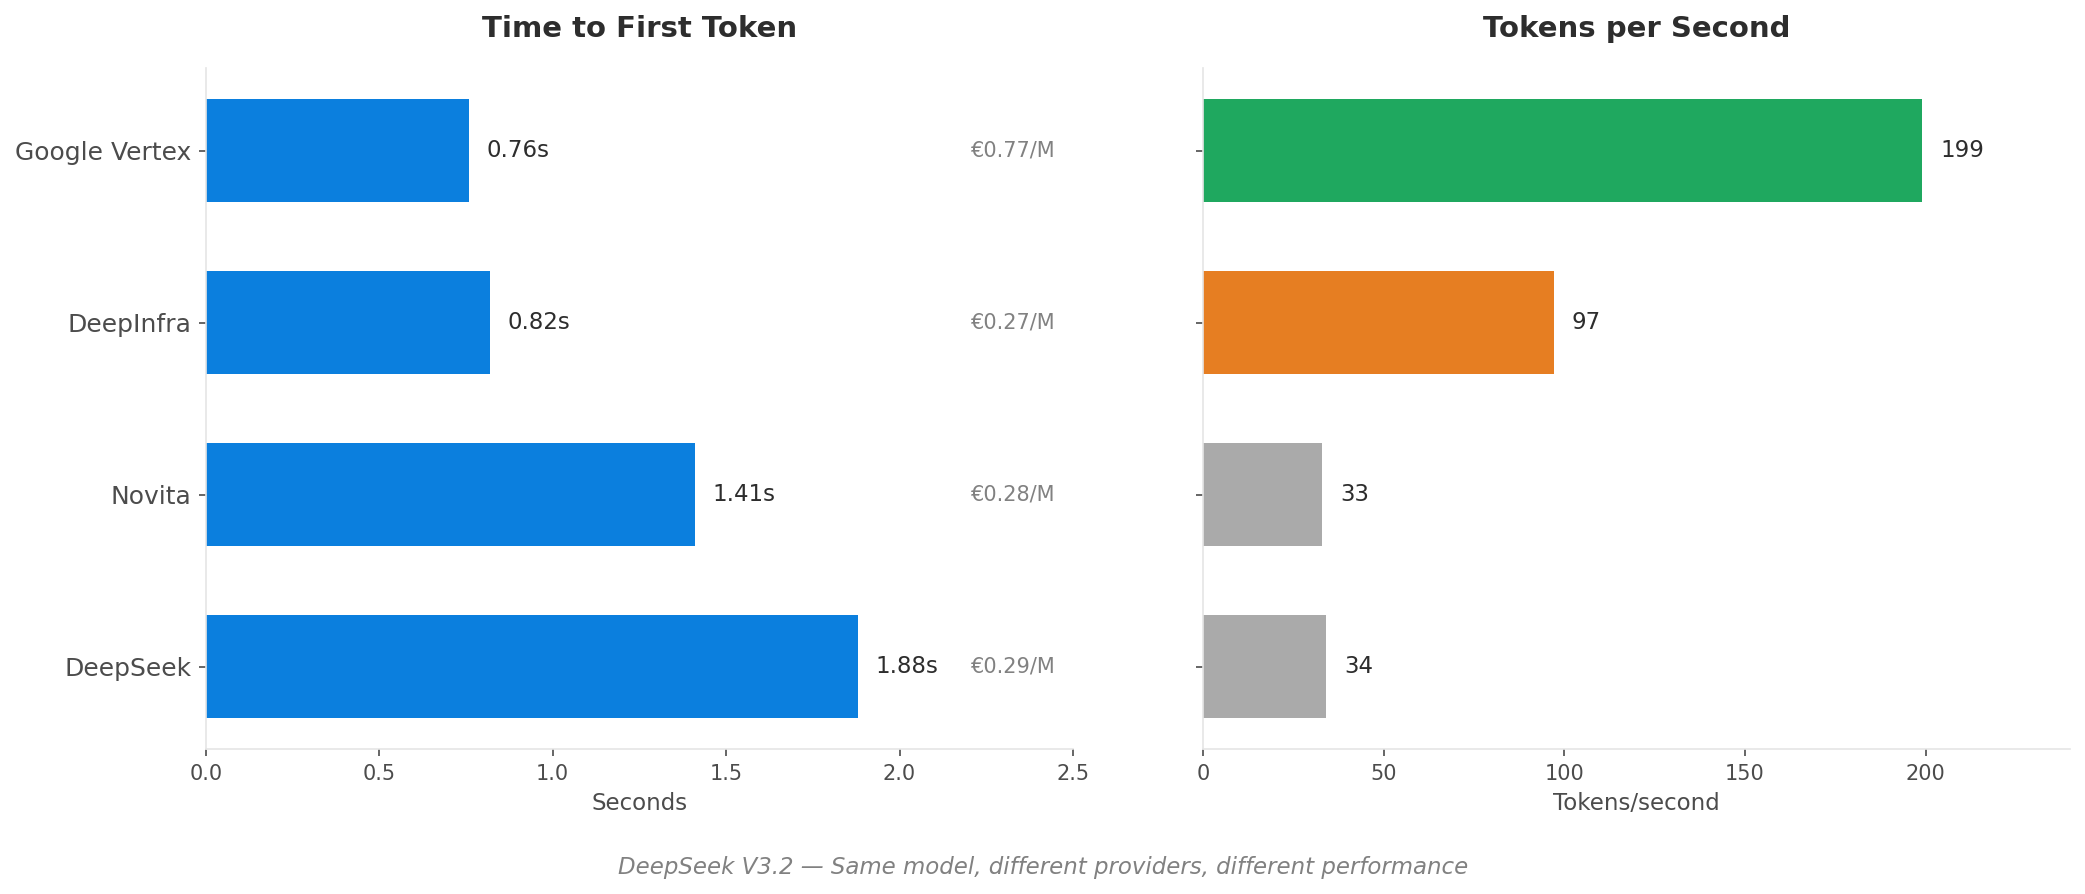
Hvad 'Pris per Token' ikke fortæller dig
Hvis du sammenligner AI-inferensudbydere kun efter tokenpris, overser du de faktorer, der faktisk bestemmer omkostninger og ydeevne.