Wenn Sie KI-gestützte Produkte entwickeln, brauchen Sie Inferenz: die Möglichkeit, einen Prompt an ein Modell zu schicken und eine Antwort zu bekommen. Solange Sie keine eigenen GPUs betreiben, kaufen Sie diese Leistung bei einem Anbieter ein.
Ist das Modell gewählt, haben Sie oft die Wahl, wo es laufen soll. Open-Source-Modelle wie MiniMax, gpt-oss oder Mistral werden von Dutzenden konkurrierender Anbieter bereitgestellt. Selbst proprietäre Modelle wie GPT oder Claude sind neben den APIs ihrer Hersteller über mehrere andere Kanäle erhältlich.
Also filtern Sie zuerst nach den Grundlagen: DSGVO-Konformität, Datensouveränität und, falls nötig, Zero Data Retention. Dann vergleichen Sie die Preise. Anbieter A verlangt €0,27 pro Million Token, Anbieter B €0,77 für genau dasselbe Modell (Preise zzgl. MwSt.). Eine leichte Entscheidung, oder?
Ganz so einfach ist es nicht: Dasselbe Modell mit buchstäblich identischen Gewichten kann bei verschiedenen Anbietern völlig unterschiedlich abschneiden. Der Preis pro Token ist eine notwendige Angabe, reicht aber selten aus.
Was schiefgeht
Eine Geschichte, die ich schon mehrfach erlebt habe: Ein Team entwickelt ein KI-Feature und muss einen Anbieter auswählen. Es vergleicht die Token-Preise, sieht, dass einer €0,27 pro Million Token verlangt und ein anderer €0,77, und nimmt die günstigere Option. Die Entscheidung wirkt offensichtlich.
Drei Monate später zeigen sich die Probleme. Nutzer beschweren sich, dass sich die KI "langsam anfühlt". Agentische Workflows, die in 2 Minuten fertig sein sollten, brauchen 15. Lange Dokumente führen zu Timeouts. Zu Spitzenzeiten wird die Qualität unberechenbar.
Also wechselt das Team den Anbieter, nachdem es Monate an Integrationsarbeit verloren und seine Nutzer frustriert hat.
Nicht der Anbieter war das Problem, sondern die Art, wie das Team ihn bewertet hat.
Warum der Preis pro Token in die Irre führt
Ein Blick auf echte Benchmark-Daten zeigt es. DeepSeek V3.2 bei vier Anbietern:
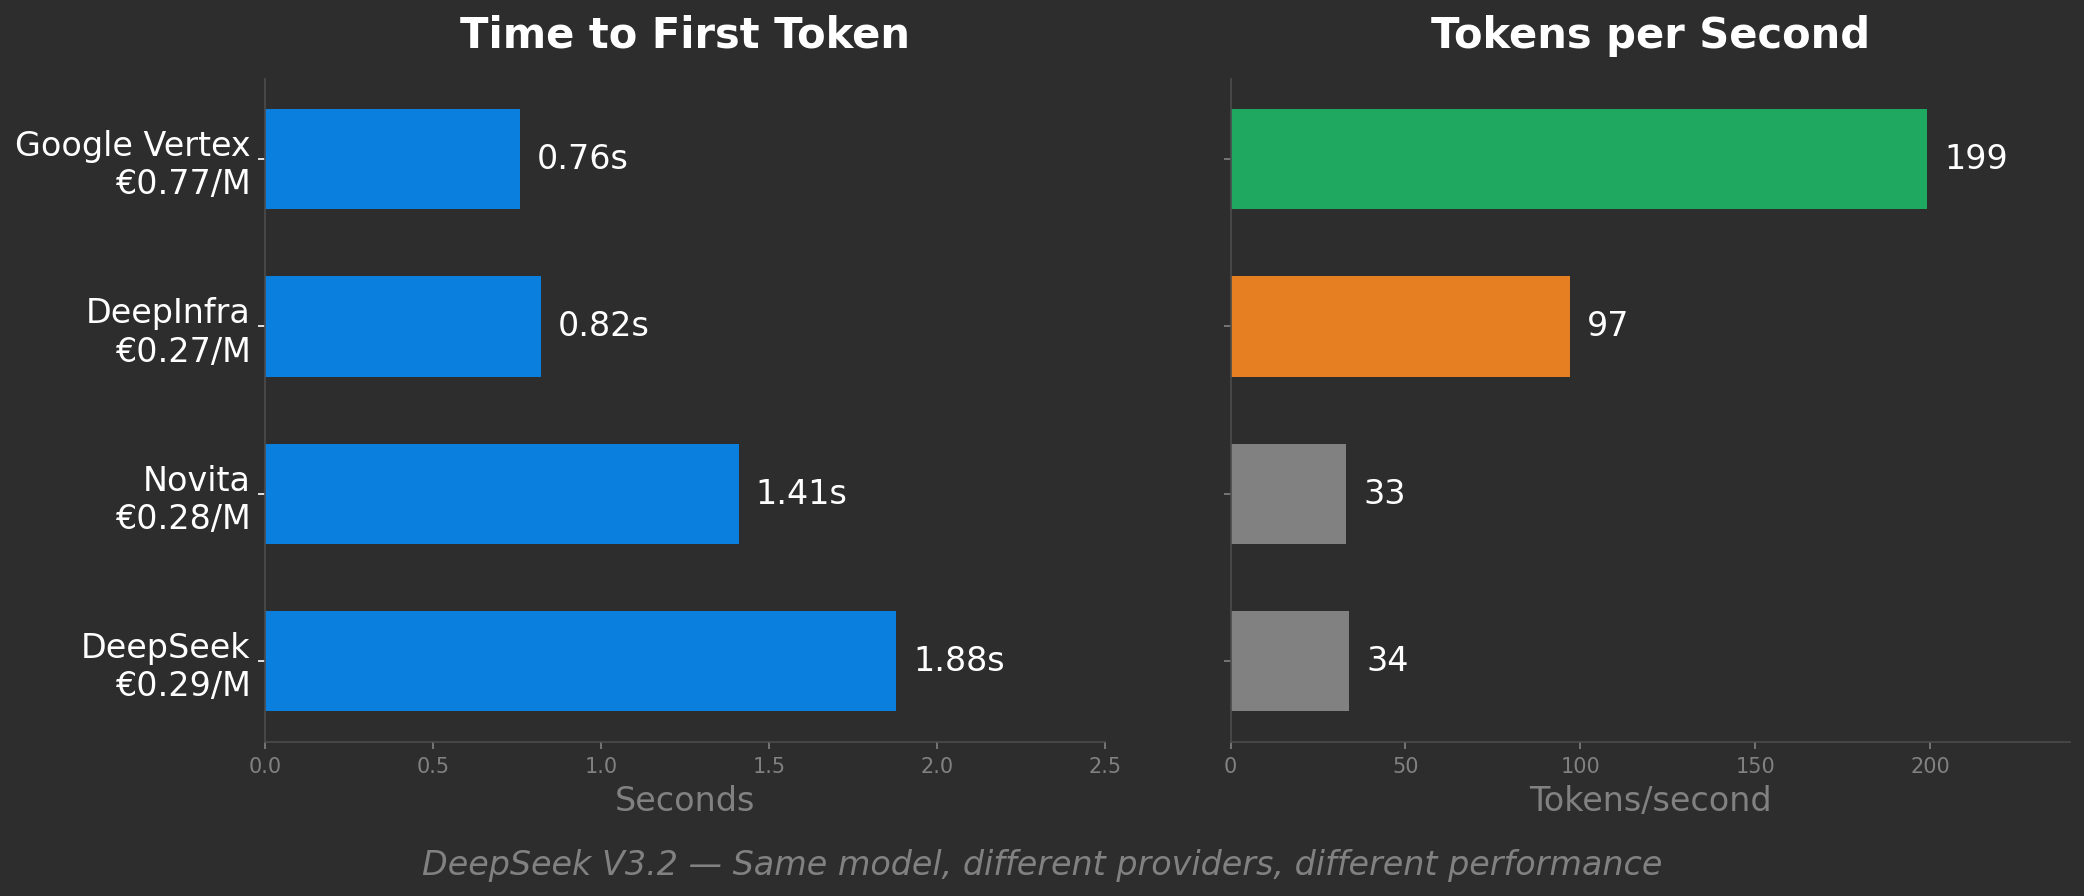
DeepInfra wirkt wie die kluge Wahl: halb so schnell wie Google Vertex, aber zu einem Drittel des Preises. Novita und die native API von DeepSeek sind ähnlich günstig, aber 6x langsamer als Vertex.
Nichts davon verrät Ihnen der "Preis pro Token". Er behandelt alle vier als gleichwertige Produkte, und das sind sie nicht.
Worauf es ankommt: fünf Faktoren
Wenn Sie einen Prompt an eine Inferenz-API senden, übernimmt die Infrastruktur des Anbieters. Ihr Request landet in einer Warteschlange und wird an die Hardware weitergeleitet, das Modell verarbeitet Ihre Eingabe, und die Token strömen zurück. Fünf Faktoren bestimmen, wie gut dieser Ablauf funktioniert und ob der Anbieter zu Ihrem Anwendungsfall passt:
Time to First Token (TTFT): Wie lange dauert es, bis die Ausgabe erscheint? Nutzer müssen sehen, dass etwas passiert. Eine TTFT von 200ms wirkt reaktionsschnell. Bleibt der Bildschirm 2 Sekunden leer, wirkt die Anwendung kaputt, auch wenn die gesamte Antwortzeit am Ende gleich ist. Die TTFT enthält auch die Netzwerklatenz: Ruft ein Nutzer in der EU einen Anbieter in den USA auf, kommen 100-150ms hinzu, bevor die Inferenz überhaupt beginnt. Und Durchschnittswerte täuschen: Produktionssysteme scheitern an der p95/p99-Latenz, nicht am Median.
Token pro Sekunde: Wie schnell kommen die Token nach dem ersten? Davon hängt ab, wann Sie die vollständige Antwort haben. In einer Chat-Oberfläche lesen Nutzer mit, während die Antwort hereinströmt, deshalb zählen die Token pro Sekunde dort weniger. Bei einem agentischen Workflow, der vor dem nächsten Schritt auf die vollständige Antwort wartet, entscheiden sie alles. Auch hier zählt die Verteilung: Konstante 80 tok/s sind besser als schwankende 50-150 tok/s.
Wenn Sie schon an Web-Performance gearbeitet haben (Core Web Vitals, Lighthouse-Scores), kennen Sie den Unterschied zwischen dem Moment, in dem etwas erscheint, und dem, in dem es nutzbar ist. TTFT entspricht dem First Contentful Paint, die Token pro Sekunde entsprechen der Time to Interactive.
Kapazität: Kann der Anbieter Ihr Volumen bewältigen? Dazu gehören Rate Limits, Grenzen für gleichzeitige Requests und die Frage, ob die Leistung unter Last nachlässt. Ein Anbieter kann in Ihrem Proof of Concept schnell sein und Sie in der Produktion trotzdem drosseln.
Kontextverarbeitung: Bleibt die Leistung bei langen Eingaben stabil? Ein Prompt mit 4K und einer mit 64K Token kosten pro Token gleich viel, verursachen beim Anbieter aber sehr unterschiedliche Kosten. Manche Anbieter werden dann deutlich langsamer, andere drosseln, wieder andere verlangen mehr.
Qualität: Bekommen Sie volle Präzision, oder betreibt der Anbieter stillschweigend eine komprimierte Version des Modells, um Speicher zu sparen? Geringere Präzision kann zu subtil schlechteren Ausgaben führen, vor allem bei schwierigem Reasoning oder Aufgaben mit langem Kontext.
Jeder Anbieter wägt zwischen diesen fünf Faktoren und dem Preis ab. Wer einen davon optimiert, zahlt oft bei einem anderen drauf. Die entscheidende Frage lautet deshalb: Welche Abwägungen passen zu meinem Workload?
Verschiedene Workloads, verschiedene Prioritäten
Welche Abwägungen richtig sind, hängt ganz davon ab, was Sie bauen. Ein Chatbot und eine Batch-Pipeline haben entgegengesetzte Prioritäten. Was dem einen hilft, schadet dem anderen.
Die folgende Übersicht zeigt grob, wie die fünf Faktoren typischerweise gewichtet sind. Ihr Anwendungsfall kann davon abweichen (ein Chatbot mit sehr langen Gesprächen braucht eine bessere Kontextverarbeitung als ein typischer), aber als Ausgangspunkt taugt sie:
| Workload | TTFT | Token/s | Kapazität | Kontext | Qualität |
|---|---|---|---|---|---|
| Interaktiver Chat | ●●● | ● | ●● | ● | ●●● |
| Batch-Verarbeitung | ● | ● | ●●● | ● | ●● |
| Agentische Workflows | ● | ●●● | ●● | ●●● | ●●● |
| Voice AI / Echtzeit | ●●● | ●●● | ●● | ● | ●●● |
| RAG / Retrieval | ●● | ● | ● | ●●● | ●●● |
●●● = kritisch, ●● = wichtig, ● = weniger wichtig
Beispiel: agentische Workflows. Einen Agenten, der 50 Inferenz-Aufrufe für eine Aufgabe braucht, kümmert die TTFT wenig, denn zwischen den Schritten schaut kein Mensch zu. Die Token pro Sekunde summieren sich dagegen: Erzeugt jeder Aufruf 500 Token, dauert er bei 100 tok/s 5 Sekunden, bei 30 tok/s 17 Sekunden. Bei 50 Aufrufen sind das 4 gegenüber 14 Minuten für dieselbe Aufgabe. Auch die Kontextverarbeitung zählt: Die Unterhaltungen eines Agenten wachsen während der Arbeit, und Anbieter, die ab 32K Token langsamer werden, bremsen Ihren Workflow aus.
Wenn Sie Ihren Workload kennen, können Sie Anbieter fundiert bewerten. Vorher lohnt es sich aber zu verstehen, warum es diese Zielkonflikte überhaupt gibt.
Warum es diese Zielkonflikte gibt
Die meisten Inferenz-Anbieter arbeiten mit GPUs, deshalb beschreiben die folgenden Zielkonflikte GPU-basierte Infrastruktur. Alternative Architekturen wie die TPUs von Google oder die Dataflow-Chips von SambaNova lösen einige davon anders, doch GPUs bleiben der Maßstab der Branche.
Prefill vs. Decode: zwei verschiedene Probleme
Wenn Sie einen Request an ein LLM senden, laufen zwei getrennte Phasen ab:
Prefill (Verarbeitung Ihrer Eingabe): Das Modell liest Ihren gesamten Prompt und ermittelt, wie jedes Wort mit jedem anderen zusammenhängt (das nennt man "Attention"). Dabei verarbeitet es alle Input-Token gleichzeitig und parallel. Für diese Art paralleler Arbeit sind GPUs hervorragend geeignet und entsprechend hoch ausgelastet.
Decode (Erzeugung der Ausgabe): Jetzt erzeugt das Modell die Output-Token eines nach dem anderen. Die Gewichte liegen im GPU-Speicher, doch für jedes Token muss die GPU sie komplett lesen, um die nächste Vorhersage zu berechnen. Der Engpass ist die Speicherbandbreite, nicht die Rechenleistung. Die GPUs warten untätig auf Daten, und ihre Auslastung sinkt deutlich.
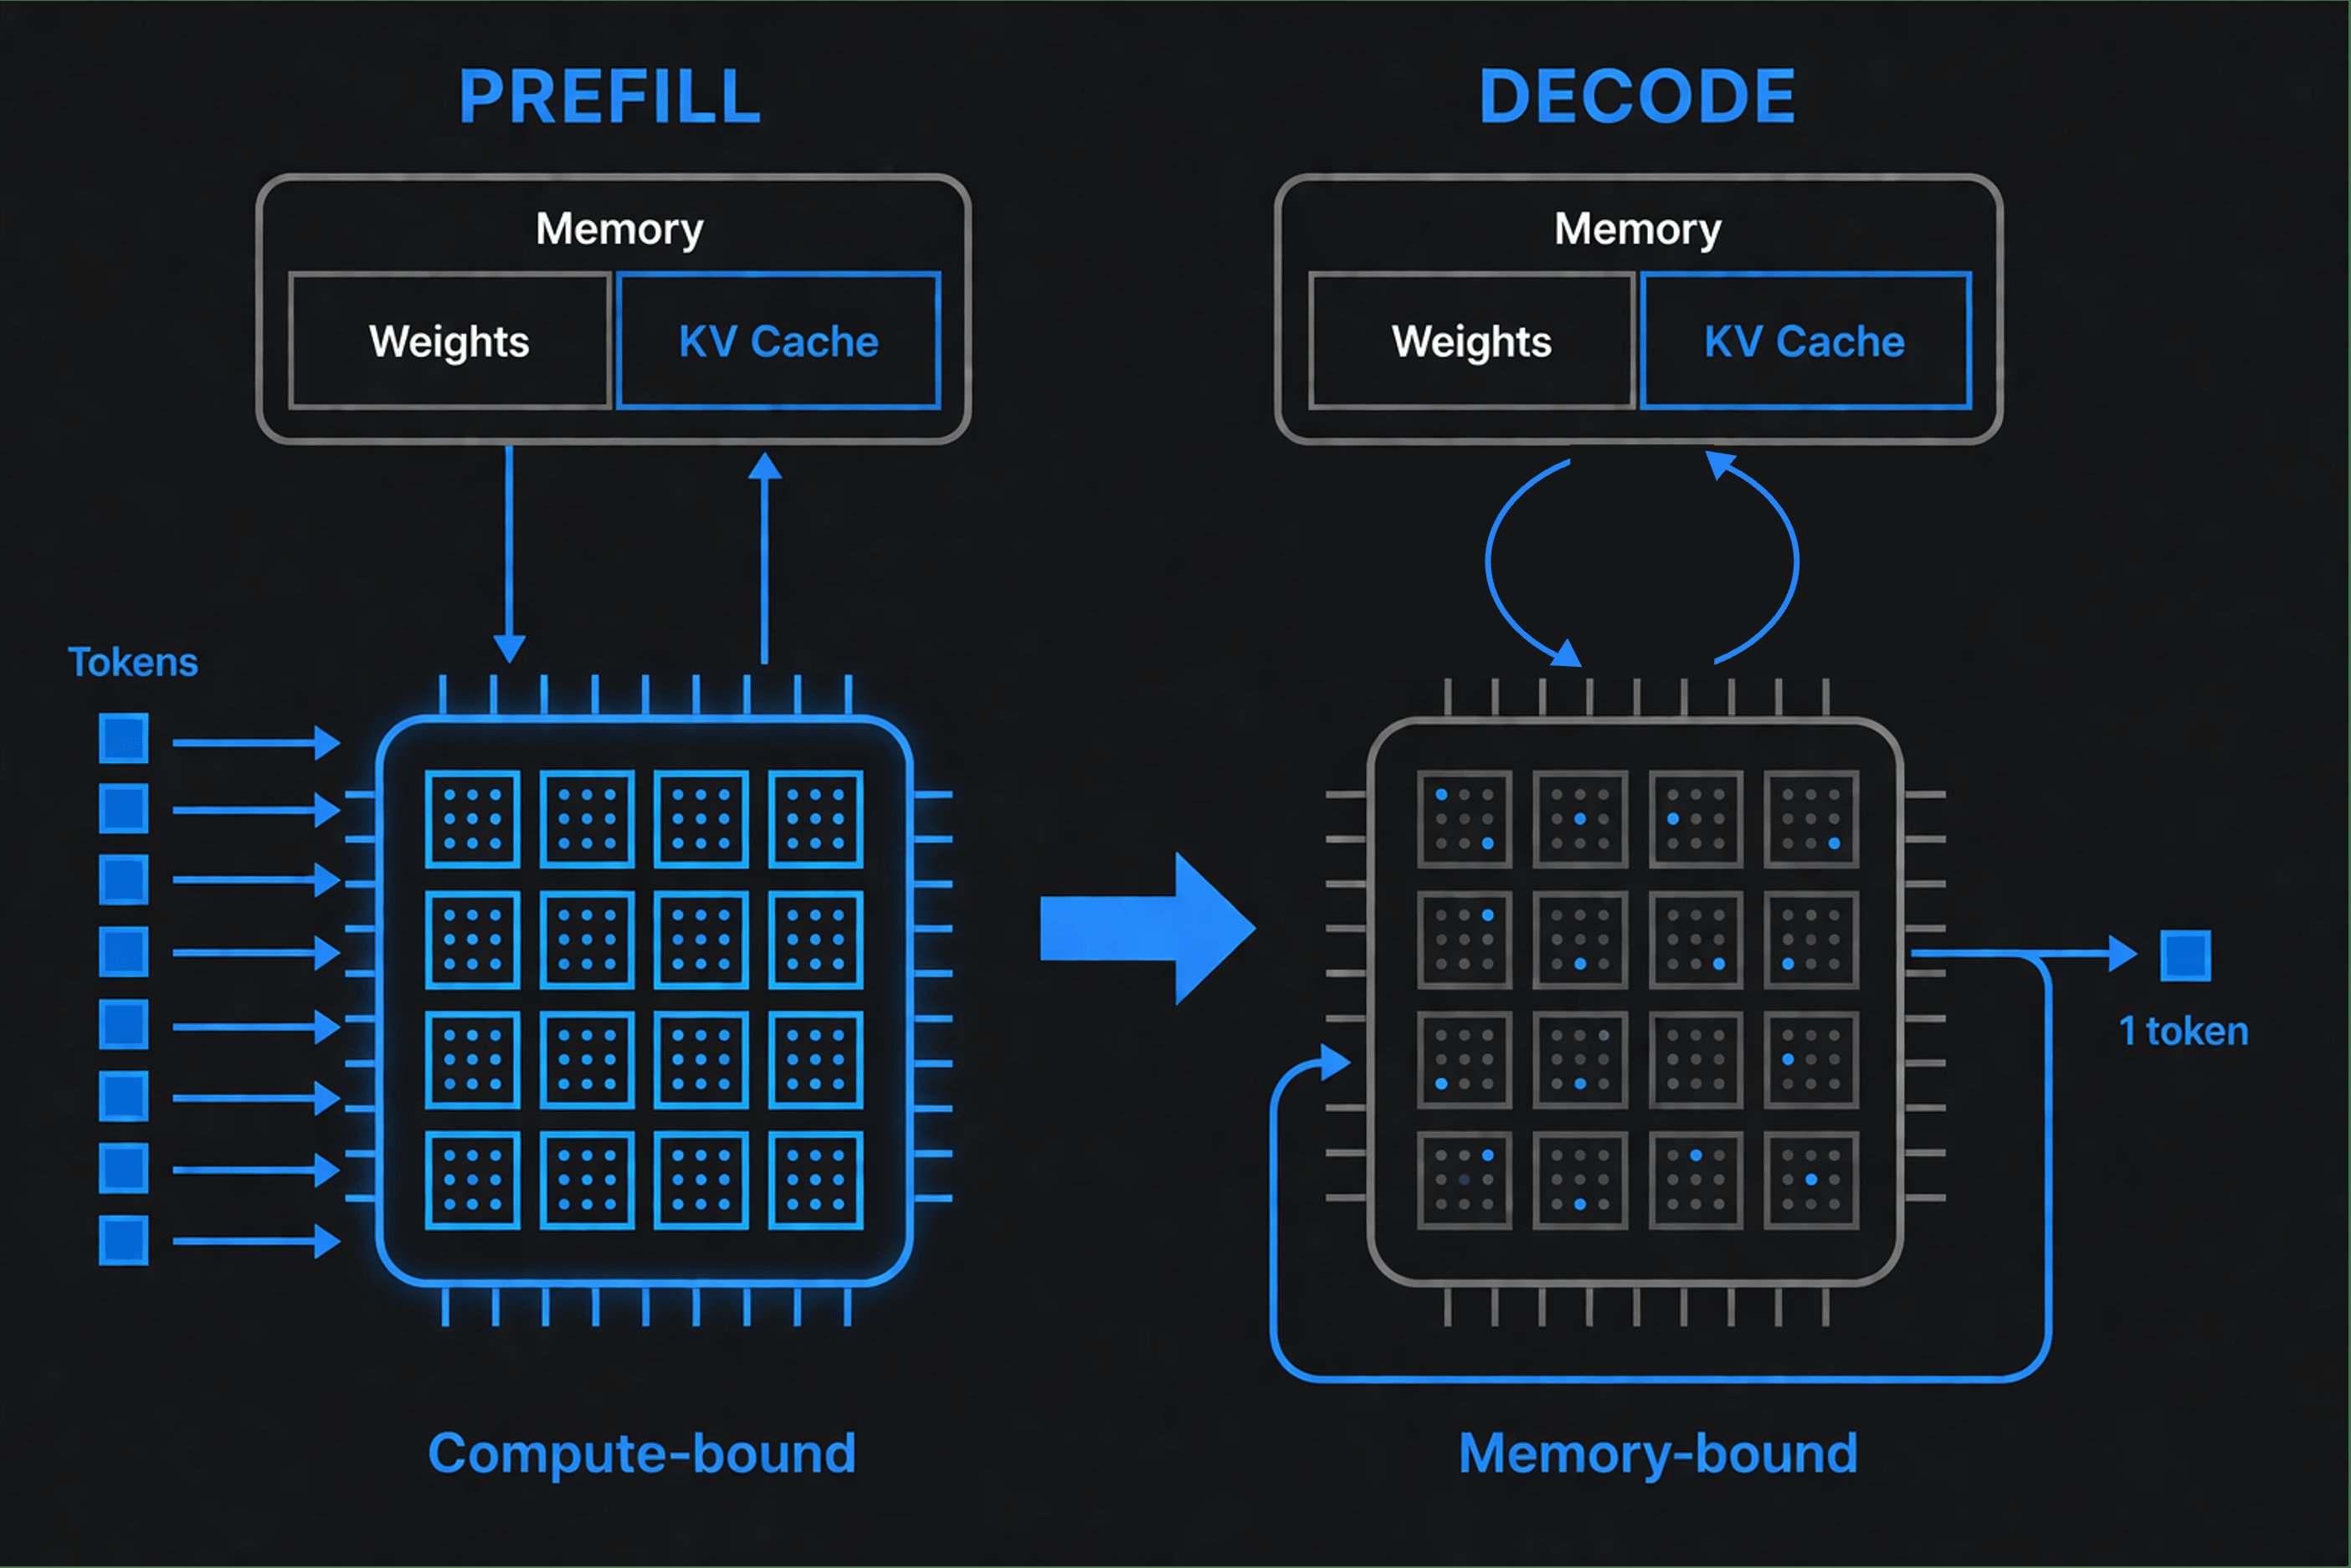
Daraus ergeben sich zwei getrennte Metriken:
- Time to First Token (TTFT): Wie lange es dauert, bis die Ausgabe beginnt, bestimmt das Prefill.
- Token pro Sekunde: Wie schnell die Token danach bei Ihnen ankommen, bestimmt das Decode.
Ein Anbieter, der auf Prefill optimiert, zeigt eine schnelle TTFT, hat aber möglicherweise ein langsames Decode. Einer, der auf Decode optimiert, streamt schnell, braucht aber länger bis zum Start. Keiner von beiden ist "besser", es hängt von Ihrem Workload ab.
Kontextlänge: der versteckte Kostenmultiplikator
Die meisten Anbieter verlangen denselben Preis pro Token, unabhängig von der Kontextlänge. Die Rechenkosten bleiben dabei aber nicht gleich.
Prefill wächst quadratisch, zumindest mit der Standard-Attention von Transformern. Das Modell berechnet, wie jedes Wort mit jedem anderen zusammenhängt. Ein Prompt mit 1000 Token bedeutet 1 Million solcher Berechnungen, einer mit 10.000 Token 100 Millionen. Verdoppeln Sie den Kontext, vervierfacht sich der Rechenaufwand für die Attention ungefähr. (Moderne Optimierungen wie FlashAttention mildern das in der Praxis ab, der Skalierungsdruck bleibt aber bestehen.)
Echte Zahlen von Meta aus dem Betrieb von Llama 3 405B:
- 128K Token: 3,8 Sekunden Prefill
- 1M Token: 77 Sekunden Prefill
Auch das Decode wird mit wachsendem Kontext langsamer. Während der Generierung legt das Modell Zwischenergebnisse im "KV-Cache" ab, einer Art Notizblock für den bisherigen Gesprächsverlauf. Dieser Cache wächst linear mit dem Kontext. Ein Gespräch mit 128K Token braucht bei einem 70B-Modell allein für den Cache rund 40 GB.
Für jedes neue Token liest das Modell den gesamten Cache. Ein größerer Cache verbraucht mehr Speicherbandbreite, und die Token pro Sekunde sinken. Da sich viele Nutzer den Speicher teilen, bedeuten größere Caches außerdem weniger gleichzeitige Nutzer.
Wie gehen Anbieter damit um? Es gibt drei Wege:
- Quersubventionierung: Nutzer mit kurzem Kontext zahlen für Nutzer mit langem Kontext
- Gestaffelte Preise: Google verlangt für Kontext über 200K Token 2x so viel
- Schlechterer Service: Requests mit langem Kontext werden gedrosselt oder nachrangig behandelt
Ist Ihr Workload kontextlastig, spielt das eine große Rolle. Arbeiten Sie mit kurzen Prompts, subventionieren Sie womöglich andere.
Batching: Wie Anbieter Ihre Token/s gegen ihre Kapazität tauschen
Was ist Batching? Statt einen Request nach dem anderen abzuarbeiten, fassen Anbieter mehrere Requests zusammen und verarbeiten sie gleichzeitig. Das nutzt die GPU effizienter, so wie ein Bus mit 50 Fahrgästen statt 50 Taxis.
Bei einer Batch-Größe von 1 sind GPUs kaum ausgelastet, weil sie auf den Speicher warten. Bei einer Batch-Größe von 128 laden sie die Modellgewichte einmal und verarbeiten alle 128 Requests zusammen. So kann der Anbieter weit mehr Nutzer bedienen, und die Kapazität steigt.
Der Haken: Ihre Token pro Sekunde sinken. Ein Modell, das einem einzelnen Nutzer 400 tok/s liefert, schafft im Batch mit 127 anderen vielleicht noch 30-50 tok/s pro Nutzer. Alle warten auf alle. (Moderne Systeme verringern diesen Zielkonflikt mit Continuous Batching, beseitigen ihn aber nicht.)
Für Batch-Workloads ist das kein Problem. Hier soll der Anbieter die Kapazität maximieren, und die Token pro Sekunde des einzelnen Requests spielen keine Rolle.
Für interaktive Workloads ist das fatal. Ihre Nutzer interessiert nicht, dass das System in dieser Sekunde 10.000 Requests verarbeitet hat. Sie interessiert, dass ihre Antwort 3 Sekunden gedauert hat.
Wenn ein Anbieter "Requests pro Sekunde" oder "Token pro Sekunde" nennt, fragen Sie nach: Ist das die Kapazität des Gesamtsystems oder die Geschwindigkeit, die jeder einzelne Nutzer erlebt? Das sind sehr unterschiedliche Zahlen.
Quantisierung: die Präzision, die Ihnen niemand nennt
Was ist Quantisierung? KI-Modelle speichern ihr Wissen als Milliarden von Zahlen, den "Gewichten". Diese lassen sich mit unterschiedlicher Genauigkeit speichern, ähnlich wie man in Millimetern oder in Zentimetern messen kann. Geringere Präzision spart Speicher, kann aber die Qualität der Ausgaben verschlechtern.
| Präzision | Speicherersparnis | Qualitätsauswirkung |
|---|---|---|
| FP16/BF16 | Ausgangswert | Keine (die meisten Modelle werden damit trainiert) |
| FP8 | ~50% | Minimal (<1% Genauigkeitsverlust) |
| INT8 | ~50% | Gering (99%+ der Genauigkeit bleiben erhalten) |
| INT4 | ~75% | Deutlich bei anspruchsvollen Aufgaben |
FP8 und INT8 fallen bei den meisten Workloads kaum auf. Bei INT4 können Probleme entstehen: Studien zeigen im ungünstigsten Fall bis zu 59% Genauigkeitsverlust bei Aufgaben mit langem Kontext und 69,8% Verschlechterung bei schwierigem Reasoning. Die Auswirkung hängt stark von der Aufgabe ab. Viele reale Anwendungen verlieren deutlich weniger, aber Reasoning über langen Kontext ist besonders empfindlich.
Die meisten Anbieter nennen ihr Quantisierungsniveau nicht. Manche passen die Präzision dynamisch an die Last an: volle Präzision um 2 Uhr nachts, quantisiert zu Spitzenzeiten. Der Preis ist derselbe, das Produkt ein anderes.
Für Batch-Verarbeitung kann eine aggressive Quantisierung akzeptabel sein. Hier optimieren Sie auf Kosten, und kleine Genauigkeitsverluste sind verkraftbar.
Für Produktionsanwendungen müssen Sie wissen, welche Präzision Sie bekommen.
Warum Output-Token mehr kosten
Die meisten Anbieter verlangen für Output-Token 4-6x so viel wie für Input-Token:
| Anbieter | Input €/M | Output €/M | Verhältnis |
|---|---|---|---|
| OpenAI GPT-5.4 | €2.30 | €13.80 | 6x |
| Anthropic Claude Opus 4.6 | €4.60 | €23.00 | 5x |
| Google Gemini 3.1 Pro | €1.84 | €11.00 | 6x |
| DeepSeek V3.2 | €0.13 | €0.26 | 2x |
Quelle, umgerechnet mit ~€0,92/$
Warum? Denken Sie an den Unterschied zwischen Prefill und Decode: Die Verarbeitung der Eingabe hält die GPU beschäftigt, die Erzeugung der Ausgabe nicht. Der Multiplikator spiegelt ungefähr diesen Unterschied in der GPU-Effizienz wider.
Auffällig ist DeepSeek mit 2x. DeepSeek kombiniert MoE (671B Parameter, davon nur 37B aktiv) mit Sparse Attention, die den Rechenaufwand bei langem Kontext senkt. V4, erschienen im April 2026, geht hier noch weiter. Die Architektur verändert die Wirtschaftlichkeit.
Input-lastige Workloads (RAG, lange Prompts, kurze Antworten) profitieren von dieser Aufteilung. Output-lastige Workloads (Code-Generierung, Content-Erstellung) trifft der Multiplikator von 4-6x.
Anbieter für Ihren Workload bewerten
Mit diesem Wissen können Sie die richtigen Fragen stellen.
Weiterlesen
Für interaktive, nutzerorientierte Workloads:
"Wie hoch ist Ihre TTFT bei p50 und p99 für meine Kontextlänge?"
Benchmarks im Leerlauf sagen wenig. Fragen Sie nach Werten unter Last.
Warnsignal: Der Anbieter hat nur synthetische Benchmarks.
"Wie viele Token pro Sekunde bekommt jeder einzelne Nutzer?"
Gemeint sind die Token pro Sekunde, die bei jedem Nutzer ankommen, nicht die Gesamtkapazität des Systems.
Warnsignal: Der Anbieter nennt "bis zu"-Werte oder systemweite Metriken.
Für Batch-Verarbeitung:
"Wie hoch ist Ihre maximale Dauerkapazität?"
Gemeint ist die Gesamtzahl an Token pro Stunde, die Sie durchschleusen können.
Warnsignal: Der Anbieter kann Kapazitätsmetriken nicht von der Geschwindigkeit pro Nutzer trennen.
"Mit welcher Präzision arbeiten Sie bei hohem Volumen?"
INT4 im großen Maßstab kann für Ihren Anwendungsfall durchaus in Ordnung sein.
Warnsignal: Der Anbieter legt seine Quantisierungsstufen nicht offen.
Für agentische Workloads und langen Kontext:
"Wie viele Token pro Sekunde liefern Sie bei 32K, 64K und 128K Kontext?"
Agentische Workflows warten auf vollständige Antworten. Deshalb sind die Token pro Sekunde bei langem Kontext entscheidend.
Warnsignal: Der Anbieter nennt nur die TTFT oder hat keine Aufschlüsselung nach Kontextlänge.
"Wie stark lässt die Leistung bei gleichzeitigen Requests mit langem Kontext nach?"
Langer Kontext belegt Speicher, der sonst anderen Nutzern dienen könnte. Was passiert im großen Maßstab?
Warnsignal: Der Anbieter versteht die Frage nicht.
Für Voice und Echtzeit:
"Wie hoch ist Ihre End-to-End-Latenz für Speech-to-Text → LLM → Text-to-Speech?"
Unter 500ms, sonst ist es keine Echtzeit.
Warnsignal: Der Anbieter nennt nur die LLM-Latenz, nicht die der gesamten Pipeline.
Warum das gerade jetzt wichtig ist
Die Zeit der KI-Flatrates, bei denen man so viel nutzen kann, wie man will, geht zu Ende.
GitHub hat Copilot kürzlich auf nutzungsbasierte Abrechnung umgestellt. Anthropic verschärft die Limits der Claude-Abos, weil die agentische Nutzung über das hinausgeht, wofür Flatrate-Pläne gedacht waren. Diese Änderungen auf Anwendungsebene spiegeln wider, was darunter passiert: Inferenz kostet Geld, und je mehr Token Sie verbrauchen, desto teurer wird es, Sie zu bedienen. Wenn die Subventionen wegfallen, die unbegrenzte Pläne bisher finanziert haben, wird es wichtiger zu verstehen, was Sie auf der Inferenz-Ebene tatsächlich kaufen.
Einige Anbieter machen das inzwischen explizit, etwa Google mit den Stufen Flex und Priority oder Amazon Bedrock mit gestaffelten Preisen. Sie erkennen damit an, dass Geschwindigkeit einen eigenen Wert hat. Mit größeren Modellen verschärfen sich diese Zielkonflikte noch: Modelle mit Billionen Parametern passen nicht auf eine einzelne GPU und erfordern aufwendige Parallelisierung, was schnelle Inferenz noch schwieriger macht.
Anbieter, die nur über den Preis konkurrieren, sparen an Stellen, die Sie nicht sehen: Quantisierung, Batching, Drosselung. Anbieter, die bei den Metriken antreten, die für Ihren Workload zählen, verlangen mehr, und sie sind es wert.
Vergleichen Sie nicht länger den Preis pro Million Token. Beginnen Sie mit den fünf Faktoren und finden Sie die Abwägungen, die zu Ihrem Workload passen.
Infercom veröffentlicht Benchmarks in Echtzeit unter infercom.ai/performance, falls Sie diese Metriken selbst vergleichen möchten.
Quellen
Benchmarks & Leistung
- DeepInfra: DeepSeek V3.2 API Benchmarks
- MLCommons MLPerf Inference v5.0
- Artificial Analysis LLM Leaderboard
Architektur & Rechenleistung
- Meta Engineering: Scaling LLM Inference
- Prefill Is Compute-Bound, Decode Is Memory-Bound
- NVIDIA: KV Cache Offloading
- Transformer FLOPs Analysis
Quantisierung
- Red Hat: vLLM FP8 Benchmarks
- Red Hat: Half Million Evaluations on Quantized LLMs
- EMNLP 2025: INT4 Long-Context Degradation
- COLM 2025: Quantization Impact on Reasoning
Preise & Wirtschaftlichkeit
Serving & Batching
Geschrieben von Thomas Vits, mit Unterstützung von KI.