Agentic coding-værktøjer bruger langt flere tokens end almindelige chat-brugerflader. Derfor påvirker inferenshastigheden direkte udviklernes produktivitet.
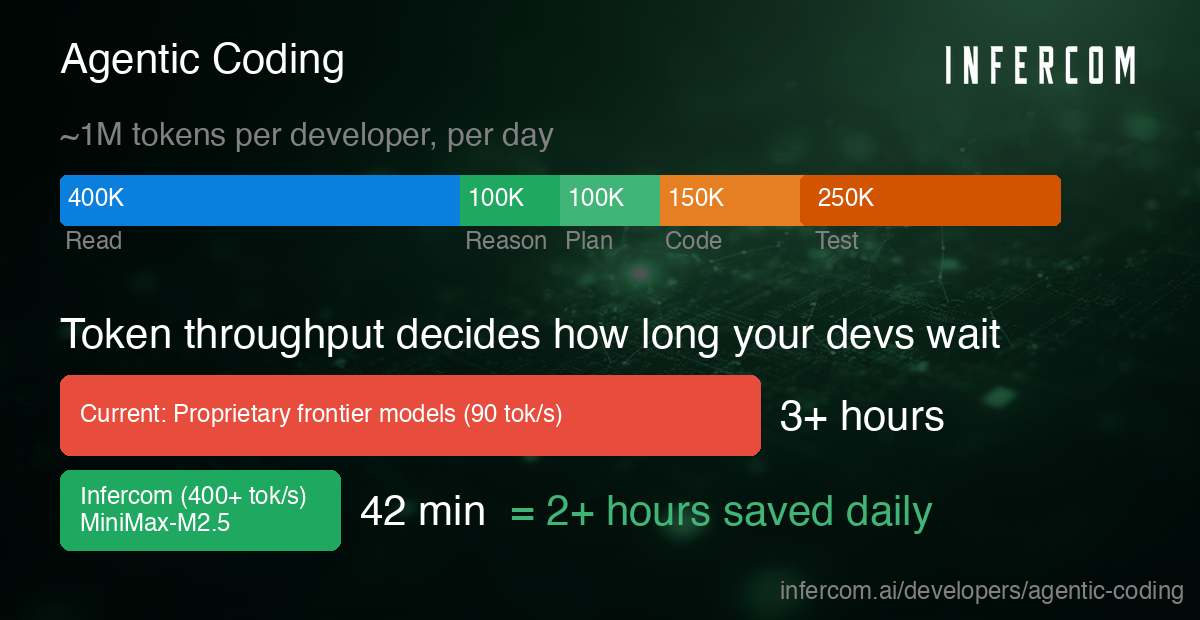
En udvikler, der bruger Cursor, Cline eller Codex CLI, forbruger typisk 500K til 2M tokens om dagen. Agentiske workflows er token-tunge: AI'en læser filer, planlægger ændringer, skriver kode, kører tests, støder på fejl og prøver igen. Hvert trin kræver et roundtrip til inferens-API'et.
Sådan påvirker inferenshastigheden ventetiden:
- Ved 90 tokens per sekund (typisk frontier-model): 1M tokens = ~3 timers inferenstid
- Ved 400+ tokens per sekund (MiniMax-M2.5): 1M tokens = ~42 minutters inferenstid
Forskellen er stor: Hurtigere inferens betyder mindre tid med at vente på svar og mere tid i et produktivt flow.
Denne artikel forklarer, hvorfor agentic coding stiller andre krav til ydeevnen end chatbaserede AI-værktøjer, og hvordan du optimerer for hastighed.
Hvorfor agentic coding-værktøjer bruger så mange tokens
I chatbaserede AI-værktøjer består en interaktion typisk af én forespørgsel og ét svar.
Agentic coding fungerer anderledes. En enkelt opgave som "refaktorér dette modul" udløser dusinvis af LLM-kald. Agenten læser filer, opbygger kontekst, planlægger sin tilgang, skriver kode, kører tests, støder på fejl, debugger og prøver igen. Hvert trin kræver et roundtrip til inferensen.
En enkelt opgave falder i to adskilte faser:
Planlægningsfase (5-15 turns):
- Forstå strukturen i kodebasen
- Analysér afhængigheder og arkitektur
- Design en migrationsstrategi
- Vurdér risici og edge cases
Udførelsesfase (50-200+ turns):
- Læs og analysér filer
- Skriv diffs og anvend ændringer
- Kør tests og registrér fejl
- Ret fejl og iterér, indtil alt er grønt
| Mønster | Turns | Tokens/session | Ventetid (90 tok/s) | Ventetid (400 tok/s) |
|---|---|---|---|---|
| Chat completion | 1-3 | 2-5K | sekunder | sekunder |
| RAG-pipeline | 3-5 | 10-30K | minutter | sekunder |
| Agentic coding | 50-200+ | 500K-2M | timer | minutter |
For at sætte tallene i perspektiv: En simpel chat completion bruger 2-5K tokens og er færdig på sekunder, uanset inferenshastigheden. En RAG-pipeline bruger 10-30K tokens og tager et par minutter ved lav hastighed, men kun sekunder ved høj throughput. Det er i agentic coding, hastigheden bliver afgørende: Med 500K til 2M tokens per session betyder forskellen mellem 90 tok/s og 400+ tok/s timer frem for minutter i samlet inferenstid per opgave.
Planlægningen har gavn af modellens intelligens, udførelsen af hastighed. Udførelsen står typisk for over 90% af alle tokens.
Tokenforbrug i en typisk agentic coding-session
Her er en opdeling af tokenforbruget i en typisk agentic coding-opgave:
Scenarie: Refaktorér et modul på tværs af 5 filer, tilføj tests og ret CI-fejl
- Læseoperationer: ~50K tokens
- Planlægning: ~20K tokens
- Kodegenerering: ~100K tokens
- Testgenerering: ~50K tokens
- Fejlrettelser (3 runder): ~80K tokens
- I alt: ~300K tokens
Ved forskellige hastigheder:
| Udbyder | Hastighed | Tid | Udvikleroplevelse |
|---|---|---|---|
| Typisk frontier-model | 60-100 tok/s | 50-83 min | Kontekstskift sandsynligt |
| MiniMax-M2.5 på Infercom | 400+ tok/s | 12 min | Fokus kan bevares |
For en opgave på 300K tokens kræver en typisk frontier-model ved 60-100 tok/s 50-83 minutters inferenstid. MiniMax-M2.5 på Infercom løser den samme opgave med 400+ tok/s på cirka 12 minutter. Den forskel på 4x eller mere afgør, om udviklerne kan holde fokus på opgaven eller må skifte kontekst, mens de venter.
Ved 300K tokens per opgave betyder forskellen mellem 12 og over 50 minutters inferenstid meget for udviklernes arbejdsgang.
Inferenshastigheden påvirker, hvordan udviklere arbejder med AI-værktøjer. Med hurtige svar kan de iterere i korte cyklusser. Med langsomme svar skifter de ofte til andre opgaver, mens de venter, og det koster også produktivitet.
To veje til hurtigere agentic coding
Der er to grundlæggende måder at forbedre inferenshastigheden for agentic coding-værktøjer på:
Option A: Fuld udskiftning
Du bruger MiniMax-M2.5 til alt. Det er den enkleste opsætning:
- Én model, én udbyder
- 75,8% på SWE-bench Verified - på niveau med frontier-modellerne
- 400+ tokens per sekund på EU-infrastruktur
- Enklest mulige konfiguration, laveste omkostning
Bedst til: Teams, der prioriterer hastighed og enkelhed
Codex CLI-konfiguration (fuld udskiftning):
# ~/.codex/config.toml
model = "MiniMax-M2.5"
model_provider = "infercom"

[model_providers.infercom]
name = "Infercom (EU Sovereign)"
base_url = "https://api.infercom.ai/v1"
env_key = "INFERCOM_API_KEY"
wire_api = "responses"
Option B: Opdeling i planner og executor
Du beholder din frontier-model (Claude, GPT, Gemini) til komplekse planlægningsbeslutninger og sender udførelsen videre til hurtig inferens.
Mønstret ser sådan ud:
| Fase | Turns | Hvad der sker | Prioritet for modellen |
|---|---|---|---|
| Planlægning | 5-15 | Forstå kodebasen, arkitekturbeslutninger, migrationsstrategi, risikovurdering | Kvalitet (frontier-model) |
| Udførelse | 50-200+ | Fillæsning, diffs, tests, fejl, rettelser, iteration | Hastighed (hurtig model) |
Opdelingen i planner og executor tager højde for, at planlægning og udførelse stiller forskellige krav. Planlægningen omfatter 5-15 turns, hvor modellen analyserer kodebasen, træffer arkitekturbeslutninger og vurderer risici, og her kommer en frontier-models ræsonneringsevner til deres ret. Udførelsen omfatter 50-200+ turns med filoperationer, kodegenerering, tests og iteration, og her tæller hastigheden mest. Da udførelsen står for langt størstedelen af tokens, reducerer det den samlede inferenstid markant at sende den til en hurtig model som MiniMax-M2.5, mens planlægningen bevarer frontier-kvalitet.
Over 90% af dine tokens går til udførelse, ikke til planlægning. Send dem videre til hurtig inferens.
Bedst til: Teams, der allerede har satset på en frontier-model og vil optimere hovedparten af deres tokenforbrug
Cline-konfiguration (opdeling i planner og executor):
Aktivér "Use different models for Plan and Act modes" i Cline-indstillingerne:
- Plan Model: Claude Sonnet (eller din frontier-model)
- Act Model: MiniMax-M2.5 via Infercoms API
OpenCode-konfiguration:
// opencode.json
{
  "agent": {
    "plan": {
      "model": "claude-sonnet-4-5-20250514",
      "provider": "anthropic"
    },
    "build": {
      "model": "MiniMax-M2.5",
      "provider": "infercom"
    }
  }
}
Codex CLI-konfiguration til Infercom
Codex CLI er OpenAIs open source-assistent til agentic coding. Sådan konfigurerer du den til Infercom:
Forudsætninger:
- Node.js 18+
- Infercom API-nøgle (få en her)
Installation:
npm install -g @openai/codexAngiv din API-nøgle:
export INFERCOM_API_KEY="your-key-here"
# Tilføj til ~/.zshrc eller ~/.bashrc, så den bliver gemt
Opret en konfigurationsfil (~/.codex/config.toml):
# Default settings
model = "MiniMax-M2.5"
model_provider = "infercom"
approval_mode = "suggest"  # Options: suggest, auto-edit, full-auto

# Infercom provider definition
[model_providers.infercom]
name = "Infercom (EU Sovereign)"
base_url = "https://api.infercom.ai/v1"
env_key = "INFERCOM_API_KEY"
wire_api = "responses"
Kontrollér opsætningen:
codex
# Bør vise:
# model: MiniMax-M2.5
# provider: infercom
Tip: Codex CLI bruger Responses API (/v1/responses), ikke Chat Completions. Infercom understøtter begge.
Sådan påvirker inferenshastigheden udviklernes workflow
Ud over den rene tidsbesparelse påvirker inferenshastigheden flere sider af udviklingsarbejdet.
Omkostninger ved kontekstskift: Korte ventetider (under 30 sekunder) gør det muligt for udviklere at holde fokus på den aktuelle opgave. Længere ventetider fører ofte til kontekstskift, og det koster i sig selv produktivitet at vende tilbage til den oprindelige opgave.
Iterationshyppighed: Hurtigere inferens gør det mere praktisk at eksperimentere. Udviklere kan hurtigt afprøve flere tilgange og fange problemer tidligere i udviklingsforløbet.
Feedback-loopets størrelse: Hurtige svar gør det muligt at arbejde i mindre trin. Mindre ændringer er som regel lettere at reviewe, teste og merge.
Effekten på teamniveau:
For et team på 5 personer, hvor hver udvikler sparer 2 timers ventetid på inferens om dagen, bliver det til 10 timer dagligt eller omkring 200 timer om måneden.
Med fuldt belastede omkostninger på €80 i timen svarer det til €16.000 om måneden i udviklertid, der kan bruges på produktivt arbejde.
Effekten på produktiviteten vokser med teamets størrelse og mængden af agentic coding-opgaver.
EU-dataresidency og GDPR-compliance
For teams med krav til dataresidency betyder placeringen af inferens-infrastrukturen noget.
For MiniMax-M2.5 på Infercom gælder:
- SambaNova-hardware i München, Tyskland
- Fuld GDPR-compliance
- Ikke eksponeret for den amerikanske CLOUD Act
- ISO 27001-certificeret infrastruktur
For teams i regulerede brancher (finans, sundhed, jura, offentlig sektor) kan EU-dataresidency være et compliance-krav.
Ydeevne og suverænitet:
Inferens hostet i EU er historisk blevet forbundet med lavere ydeevne end hos udbydere i USA.
MiniMax-M2.5 på Infercom viser, at høj throughput (400+ tok/s) kan opnås på EU-infrastruktur. Dermed forsvinder den traditionelle afvejning mellem datasuverænitet og inferenshastighed.
Kom i gang
Sådan prøver du Infercom med dine agentic coding-værktøjer:
- Få en API-nøgle - på cloud.infercom.ai/apis
- Konfigurer dit værktøj - Infercom understøtter Codex CLI, Cline, Cursor og andre OpenAI-kompatible værktøjer
- Test med en rigtig opgave - brug en reel udviklingsopgave til at vurdere forskellen i ydeevne
Du finder detaljerede vejledninger til hvert værktøj i vores dokumentation om agentic coding.
Konfigurationen tager typisk kun få minutter.
Kontrol af API:
curl -s https://api.infercom.ai/v1/responses \
  -H "Authorization: Bearer $INFERCOM_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"MiniMax-M2.5","input":"Write a Python function to reverse a string"}' \
  | jq '.output[0].content[0].text'
Opsummering
Agentic coding-værktøjer stiller grundlæggende andre krav til ydeevnen end chatbaserede AI-brugerflader, fordi de bruger så mange tokens.
Inferenshastigheden påvirker direkte udviklernes produktivitet gennem kortere ventetider og tættere feedback-loops.
MiniMax-M2.5 på Infercom tilbyder 400+ tok/s throughput, 75,8% nøjagtighed på SWE-bench, et kontekstvindue på 160K og EU-dataresidency.
For teams, der vurderer inferensudbydere til agentic coding-workloads, bør throughput være et af de vigtigste kriterier ved siden af modelkvalitet og krav til dataresidency.
Skrevet af Thomas Vits, med assistance fra AI.