Se sviluppi prodotti basati sull'AI, ti serve l'inferenza: la possibilità di inviare un prompt a un modello e ricevere una risposta. A meno che tu non gestisca GPU tue, questa capacità la compri da un provider.
Una volta scelto il modello, spesso puoi decidere dove farlo girare. Modelli open source come MiniMax, gpt-oss o Mistral sono offerti da decine di provider in concorrenza tra loro. Anche modelli proprietari come GPT o Claude sono disponibili attraverso più canali oltre alle API dei rispettivi produttori.
Quindi filtri prima gli elementi di base: conformità al GDPR, sovranità dei dati e, se ti serve, zero data retention. Poi confronti i prezzi. Il provider A chiede €0,27 per milione di token, il provider B €0,77 per lo stesso identico modello (prezzi IVA esclusa). Scelta facile, no?
Non è così semplice: lo stesso modello, con pesi letteralmente identici, può comportarsi in modo completamente diverso a seconda del provider. Il prezzo per token è un dato necessario, ma raramente basta.
Che cosa va storto
Ecco una storia che ho visto ripetersi più volte. Un team sta sviluppando una funzionalità AI e deve scegliere un provider. Confronta i prezzi dei token, vede che uno chiede €0,27 per milione di token e un altro €0,77, e sceglie l'opzione più economica. Sembra una decisione ovvia.
Tre mesi dopo emergono i problemi. Gli utenti si lamentano che l'AI "sembra lenta". Workflow agentici che dovrebbero finire in 2 minuti ne impiegano 15. I documenti lunghi causano timeout. Nelle ore di punta la qualità diventa imprevedibile.
Così il team cambia provider, dopo aver sprecato mesi di integrazione e frustrato gli utenti lungo la strada.
Il problema non era il provider, ma il modo in cui il team lo aveva valutato.
Perché il prezzo per token è fuorviante
Ecco dati di benchmark reali per DeepSeek V3.2 su quattro provider:
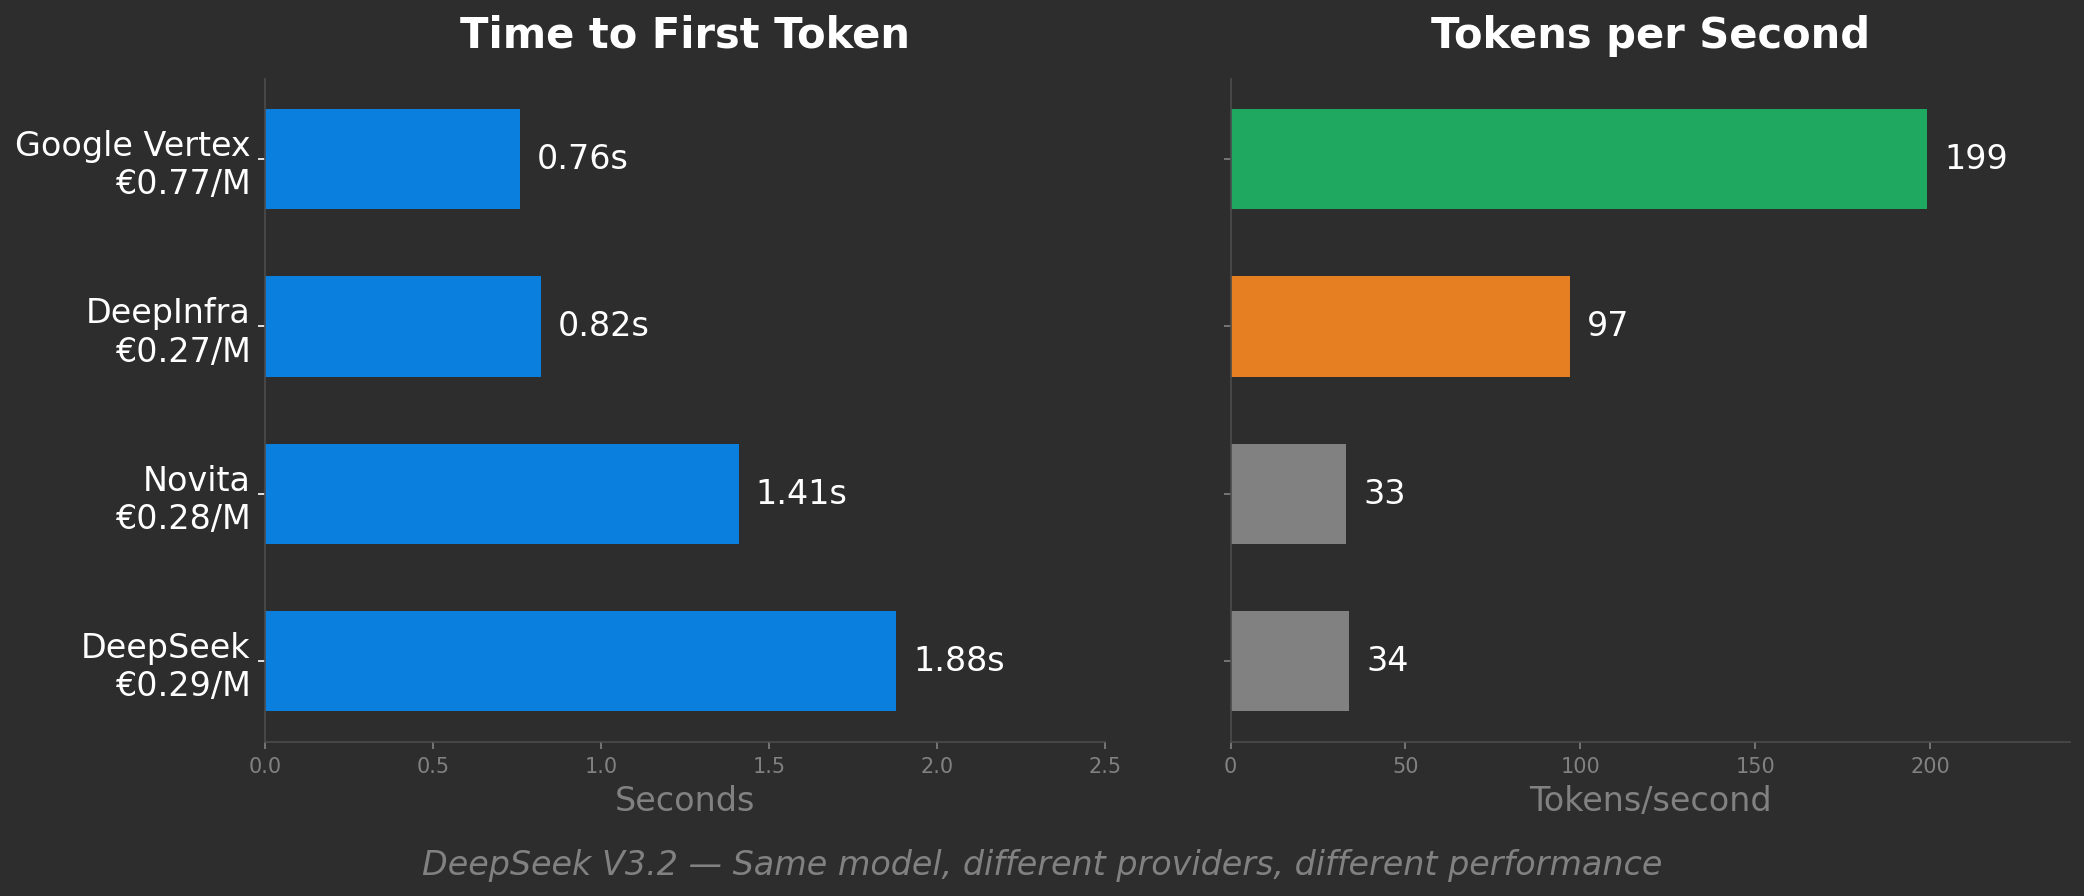
DeepInfra sembra la scelta intelligente: metà della velocità di Google Vertex, ma a un terzo del prezzo. Novita e l'API nativa di DeepSeek sono altrettanto economiche, ma 6x più lente di Vertex.
Ma il "prezzo per token" non ti dice nulla di tutto questo. Tratta tutti e quattro come prodotti equivalenti, e non lo sono.
Ciò che conta: cinque fattori
Quando invii un prompt a un'API di inferenza, entra in gioco l'infrastruttura del provider. La tua richiesta finisce in coda e viene instradata verso l'hardware, il modello elabora il tuo input e i token iniziano a tornare in streaming. Cinque elementi determinano come si comporta questo processo e se il provider è adatto al tuo caso d'uso:
Time to First Token (TTFT): Quanto tempo passa prima che l'output inizi ad apparire? Gli utenti devono capire che sta succedendo qualcosa. Un TTFT di 200ms dà un'impressione di reattività. Uno schermo vuoto per 2 secondi sembra un guasto, anche se il tempo di risposta totale alla fine è lo stesso. Ricorda che il TTFT include la latenza di rete: quando un utente nell'UE chiama un provider negli USA, si aggiungono 100-150ms prima ancora che l'inferenza inizi. E le medie ingannano: i sistemi in produzione cedono sulla latenza p95/p99, non sulla mediana.
Token al secondo: Quanto velocemente arrivano i token dopo il primo? Da questo dipende quando ricevi la risposta completa. In una chat gli utenti leggono mentre il testo arriva, quindi i token al secondo contano meno. Per un workflow agentico che aspetta la risposta completa prima del passo successivo, i token al secondo sono tutto. Anche qui conta la distribuzione: 80 tok/s costanti sono meglio di 50-150 tok/s variabili.
Se hai lavorato sulle performance web (Core Web Vitals, punteggi Lighthouse), conosci la differenza tra il momento in cui qualcosa appare e quello in cui diventa utilizzabile. Il TTFT corrisponde al First Contentful Paint, i token al secondo al Time to Interactive.
Capacità: Il provider regge il tuo volume? Contano i rate limit, i limiti sulle richieste simultanee e se le prestazioni calano con la scala. Un provider può essere veloce nel tuo proof of concept e poi limitarti in produzione.
Gestione del contesto: Le prestazioni reggono con input lunghi? Un prompt da 4K token e uno da 64K costano uguale per token, ma per il provider il costo di servirli è molto diverso. Alcuni provider rallentano drasticamente, altri limitano le richieste, altri ancora fanno pagare di più.
Qualità: Ricevi la precisione piena, o il provider esegue in silenzio una versione compressa del modello per risparmiare memoria? Una precisione più bassa può significare output leggermente peggiori, soprattutto nel ragionamento complesso o nei compiti con contesto lungo.
Ogni provider bilancia questi cinque fattori con il prezzo. Ottimizzarne uno spesso ne penalizza un altro. La domanda è: quali compromessi sono adatti al mio workload?
Workload diversi, priorità diverse
I compromessi giusti dipendono interamente da cosa stai costruendo. Un chatbot e una pipeline batch hanno priorità opposte. Ciò che aiuta l'uno danneggia l'altra.
Ecco una guida approssimativa a come pesano di solito i cinque fattori. Il tuo caso d'uso può essere diverso (un chatbot con conversazioni molto lunghe ha più bisogno di una buona gestione del contesto rispetto a uno tipico), ma è un punto di partenza:
| Workload | TTFT | Token/s | Capacità | Contesto | Qualità |
|---|---|---|---|---|---|
| Chat interattiva | ●●● | ● | ●● | ● | ●●● |
| Elaborazione batch | ● | ● | ●●● | ● | ●● |
| Workflow agentici | ● | ●●● | ●● | ●●● | ●●● |
| Voice AI / tempo reale | ●●● | ●●● | ●● | ● | ●●● |
| RAG / retrieval | ●● | ● | ● | ●●● | ●●● |
●●● = critico, ●● = importante, ● = meno importante
Esempio: workflow agentici. A un agente che esegue 50 chiamate di inferenza per completare un compito importa poco del TTFT, perché tra un passaggio e l'altro nessuno guarda. I token al secondo invece si sommano: se ogni chiamata genera 500 token, a 100 tok/s servono 5 secondi per chiamata, a 30 tok/s ne servono 17. Su 50 chiamate fanno 4 minuti contro 14 per lo stesso compito. Conta anche la gestione del contesto: le conversazioni dell'agente crescono mentre lavora, e i provider che rallentano oltre i 32K token diventano un collo di bottiglia per il tuo workflow.
Quando conosci il tuo workload, puoi valutare i provider nel modo giusto. Prima però devi capire perché esistono questi compromessi.
Perché esistono questi compromessi
La maggior parte dei provider di inferenza usa GPU, quindi i compromessi descritti qui sotto riguardano infrastrutture basate su GPU. Architetture alternative come le TPU di Google o i chip dataflow di SambaNova gestiscono alcuni di questi aspetti in modo diverso, ma le GPU restano il riferimento del settore.
Prefill e decode: due problemi diversi
Quando invii una richiesta a un LLM, si susseguono due fasi distinte:
Prefill (elaborazione del tuo input): Il modello legge l'intero prompt e calcola come ogni parola si relaziona con tutte le altre (è ciò che si chiama "attention"). Elabora tutti i token di input insieme, in parallelo. Le GPU sono eccellenti in questo tipo di lavoro parallelo e lavorano con un utilizzo elevato.
Decode (generazione dell'output): Ora il modello produce i token di output uno alla volta. I pesi stanno nella memoria della GPU, ma per ogni token la GPU deve rileggerli per calcolare la previsione successiva. Il collo di bottiglia è la banda di memoria, non la potenza di calcolo. Le GPU restano ferme in attesa dei dati, e il loro utilizzo scende molto.
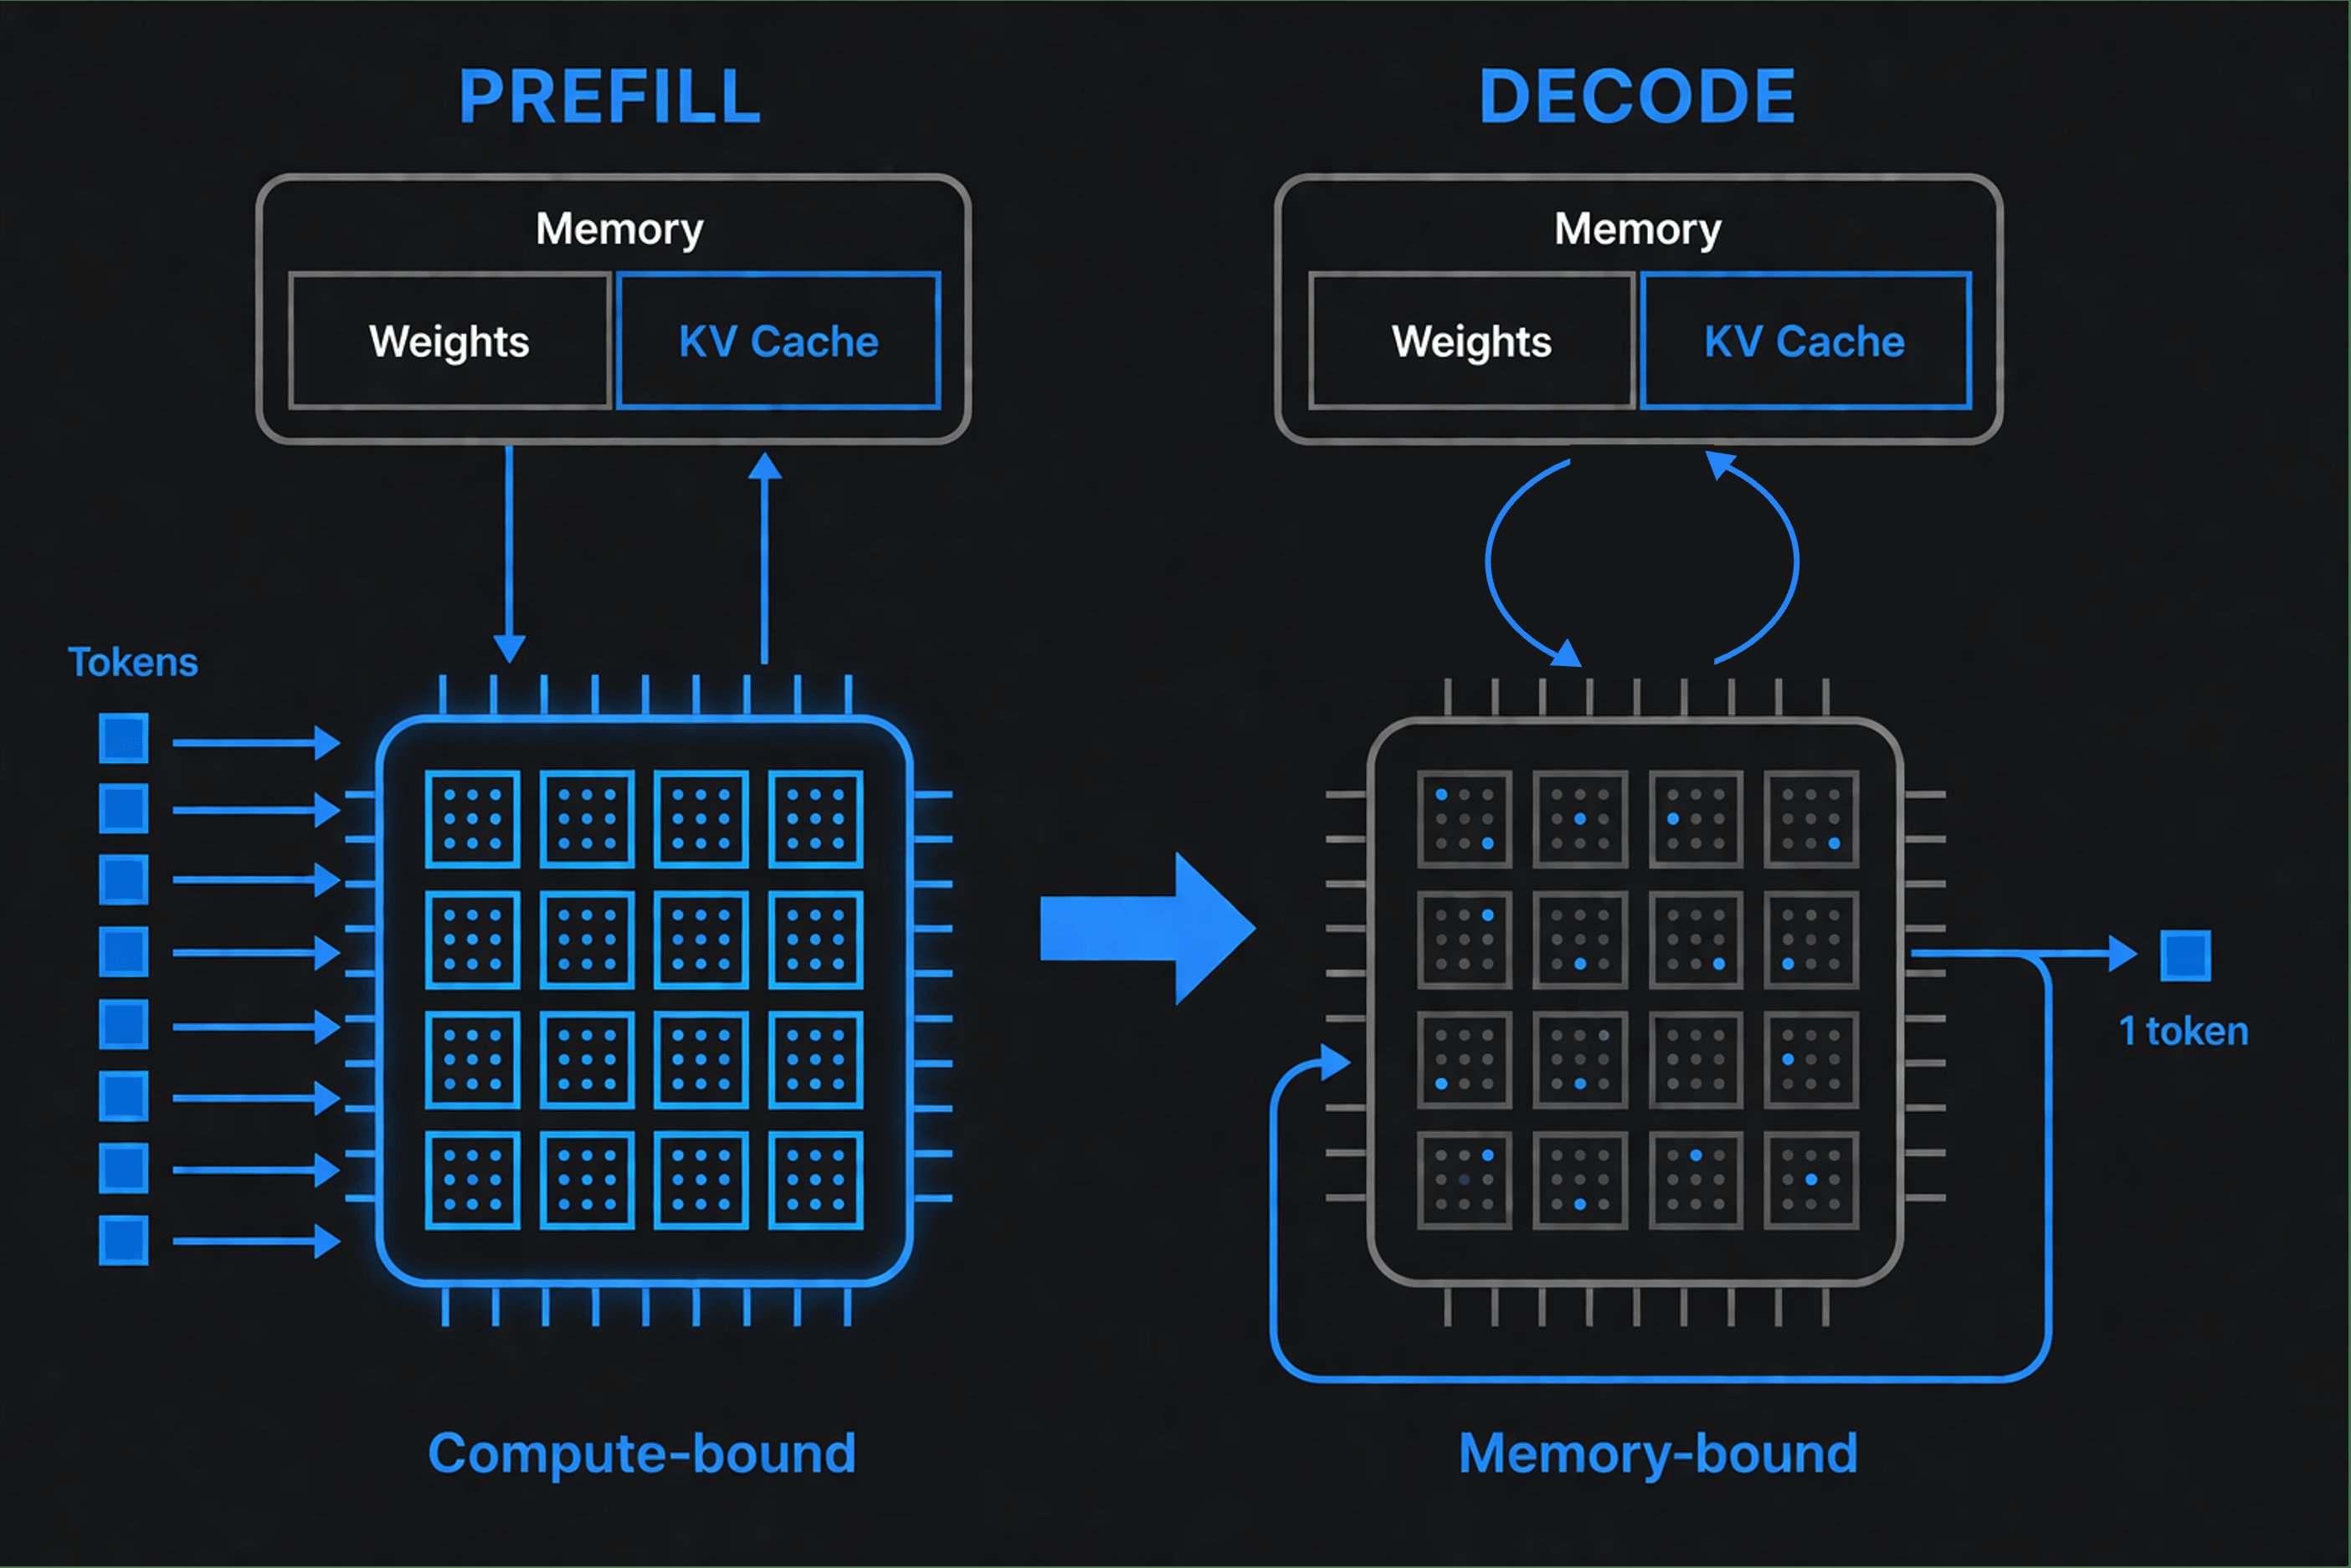
Da qui nascono due metriche distinte:
- Time to First Token (TTFT), cioè il tempo al primo token: misura quanto passa prima che l'output inizi e dipende dal prefill.
- Token al secondo: misurano quanto velocemente arrivano i token dopo il primo e dipendono dal decode.
Un provider ottimizzato per il prefill mostra un TTFT rapido, ma può avere un decode lento. Uno ottimizzato per il decode fa streaming veloce, ma impiega di più a partire. Nessuno dei due è "migliore": dipende dal tuo workload.
Lunghezza del contesto: il moltiplicatore di costo nascosto
La maggior parte dei provider applica la stessa tariffa per token indipendentemente dalla lunghezza del contesto. Il costo di calcolo, però, non è costante.
Il prefill cresce in modo quadratico con l'attention standard dei transformer. Il modello calcola come ogni parola si relaziona con tutte le altre. Un prompt da 1.000 token richiede 1 milione di calcoli di relazione, uno da 10.000 token ne richiede 100 milioni. Se raddoppi il contesto, il calcolo dell'attention circa quadruplica. (Ottimizzazioni moderne come FlashAttention riducono il problema nella pratica, ma la pressione della scala resta.)
Dati reali di Meta con Llama 3 405B:
- 128K token: 3,8 secondi di prefill
- 1M token: 77 secondi di prefill
Anche il decode rallenta con il contesto. Durante la generazione il modello salva i calcoli intermedi in una "KV cache", una specie di blocco appunti della conversazione fin qui. Questa cache cresce in modo lineare con il contesto. Una conversazione da 128K token richiede circa 40 GB solo per la cache su un modello da 70B.
Per ogni nuovo token il modello legge tutta la cache. Una cache più grande consuma più banda di memoria, e i token al secondo calano. E poiché la memoria è condivisa tra gli utenti, cache più grandi significano meno utenti simultanei.
Come lo gestiscono i provider? In tre modi:
- Sussidi incrociati: chi usa contesti brevi paga per chi usa contesti lunghi
- Prezzi a scaglioni: Google chiede 2x per il contesto oltre i 200K token
- Servizio degradato: le richieste a contesto lungo vengono limitate o messe in secondo piano
Se il tuo workload fa largo uso di contesto, questo conta. Se usi prompt brevi, potresti stare sovvenzionando altri.
Batching: come i provider scambiano i tuoi token/s con la loro capacità
Che cos'è il batching? Invece di elaborare una richiesta alla volta, i provider raggruppano più richieste e le elaborano insieme. Per la GPU è più efficiente, come un autobus con 50 persone invece di 50 taxi.
Con un batch di dimensione 1 le GPU sono poco utilizzate, perché aspettano la memoria. Con un batch di 128 caricano i pesi del modello una volta sola ed elaborano tutte le 128 richieste insieme. Il provider può servire molti più utenti, e la capacità aumenta.
Il rovescio della medaglia: i tuoi token al secondo calano. Un modello che fornisce 400 tok/s a un singolo utente può scendere a 30-50 tok/s per utente in un batch con altri 127. Tutti aspettano tutti. (I sistemi moderni usano il continuous batching per ridurre questo compromesso, ma non lo eliminano.)
Per i workload batch va bene così. Vuoi che il provider massimizzi la capacità, e i token al secondo della singola richiesta non contano.
Per i workload interattivi è pessimo. Ai tuoi utenti non importa che il sistema abbia elaborato 10.000 richieste in quel secondo. Importa che la loro risposta abbia richiesto 3 secondi.
Quando un provider indica "richieste al secondo" o "token al secondo", chiedi: si tratta della capacità totale del sistema o dei token al secondo che vede ogni utente? Sono numeri molto diversi.
Quantizzazione: la precisione di cui nessuno ti parla
Che cos'è la quantizzazione? I modelli AI memorizzano la loro conoscenza come miliardi di numeri (i "pesi"). Questi numeri si possono salvare con livelli di precisione diversi, come quando si misura in millimetri o in centimetri. Una precisione più bassa fa risparmiare memoria, ma può peggiorare la qualità dell'output.
| Precisione | Risparmio di memoria | Impatto sulla qualità |
|---|---|---|
| FP16/BF16 | Baseline | Nessuno (la maggior parte dei modelli viene addestrata così) |
| FP8 | ~50% | Minimo (<1% di perdita di accuratezza) |
| INT8 | ~50% | Lieve (99%+ dell'accuratezza preservata) |
| INT4 | ~75% | Significativo sui compiti impegnativi |
FP8 e INT8 sono quasi invisibili per la maggior parte dei workload. Con INT4 possono emergere problemi: la ricerca mostra nei casi peggiori fino al 59% di perdita di accuratezza nei compiti con contesto lungo e un degrado del 69,8% nel ragionamento complesso. L'impatto varia molto da compito a compito. Molte applicazioni reali registrano cali molto più piccoli, ma il ragionamento su contesti lunghi è particolarmente sensibile.
La maggior parte dei provider non dichiara il proprio livello di quantizzazione. Alcuni regolano la precisione in modo dinamico in base al carico: precisione piena alle 2 di notte, quantizzata nelle ore di punta. Il prezzo è lo stesso, il prodotto no.
Per l'elaborazione batch una quantizzazione aggressiva può essere accettabile. Stai ottimizzando i costi, e piccoli cali di accuratezza sono tollerabili.
Per le applicazioni in produzione devi sapere che precisione stai ricevendo.
Perché i token di output costano di più
La maggior parte dei provider fa pagare i token di output 4-6x più di quelli di input:
| Provider | Input €/M | Output €/M | Rapporto |
|---|---|---|---|
| OpenAI GPT-5.4 | €2.30 | €13.80 | 6x |
| Anthropic Claude Opus 4.6 | €4.60 | €23.00 | 5x |
| Google Gemini 3.1 Pro | €1.84 | €11.00 | 6x |
| DeepSeek V3.2 | €0.13 | €0.26 | 2x |
Fonte, convertito a ~€0,92/$
Perché? Ricorda la differenza tra prefill e decode: l'elaborazione dell'input tiene occupata la GPU, la generazione dell'output no. Il moltiplicatore riflette più o meno questa differenza di efficienza della GPU.
Nota DeepSeek a 2x. DeepSeek combina MoE (671B parametri, di cui solo 37B attivi) con una sparse attention che riduce il calcolo sui contesti lunghi. V4, uscito ad aprile 2026, spinge ancora più in là. L'architettura cambia l'economia.
I workload sbilanciati sull'input (RAG, prompt lunghi, risposte brevi) traggono vantaggio da questa ripartizione. Quelli sbilanciati sull'output (generazione di codice, creazione di contenuti) subiscono il moltiplicatore di 4-6x.
Valutare i provider per il tuo workload
Con queste conoscenze puoi fare le domande giuste.
Letture correlate
Per workload interattivi, rivolti agli utenti:
"Qual è il vostro TTFT p50 e p99 con la mia lunghezza di contesto?"
I benchmark a vuoto non contano. Chiedi numeri sotto carico.
Segnale d'allarme: hanno solo benchmark sintetici.
"Quanti token al secondo riceve ogni singolo utente?"
Contano i token al secondo che arrivano a ogni utente, non la capacità totale del sistema.
Segnale d'allarme: citano numeri "fino a" o metriche a livello di sistema.
Per l'elaborazione batch:
"Qual è la vostra capacità massima sostenibile nel tempo?"
Conta il numero totale di token all'ora che riesci a far passare.
Segnale d'allarme: non sanno separare le metriche di capacità dalla velocità per utente.
"Con che precisione servite i volumi elevati?"
INT4 su larga scala potrebbe andare bene per il tuo caso d'uso.
Segnale d'allarme: non vogliono dichiarare i livelli di quantizzazione.
Per workload agentici e con contesto lungo:
"Quanti token al secondo fornite con 32K, 64K e 128K di contesto?"
I workflow agentici aspettano risposte complete. Per questo i token al secondo con contesto lungo sono decisivi.
Segnale d'allarme: citano solo il TTFT, o non hanno una ripartizione per lunghezza del contesto.
"Quanto calano le prestazioni con richieste simultanee a contesto lungo?"
Il contesto lungo occupa memoria che potrebbe servire altri utenti. Cosa succede su larga scala?
Segnale d'allarme: non capiscono cosa stai chiedendo.
Per voice e tempo reale:
"Qual è la vostra latenza end-to-end per speech-to-text → LLM → text-to-speech?"
Sotto i 500ms, altrimenti non è tempo reale.
Segnale d'allarme: citano solo la latenza dell'LLM, non quella dell'intera pipeline.
Perché conta proprio adesso
L'era dell'AI a tariffa fissa e a consumo illimitato sta finendo.
GitHub ha da poco portato Copilot alla fatturazione a consumo. Anthropic sta stringendo i limiti degli abbonamenti Claude, perché l'uso agentico supera ciò per cui erano pensati i piani a tariffa fissa. Questi cambiamenti a livello applicativo riflettono la realtà sottostante: l'inferenza costa, e più token consumi, più costa servirti. Man mano che spariscono i sussidi che finanziavano i piani illimitati, capire che cosa stai comprando a livello di inferenza diventa più importante, non meno.
Alcuni provider lo rendono ormai esplicito, come Google con i livelli Flex e Priority o Amazon Bedrock con i prezzi a scaglioni, riconoscendo che la velocità in sé ha un valore. E questi compromessi si accentuano con i modelli più grandi: i modelli da migliaia di miliardi di parametri non entrano in una singola GPU e richiedono una parallelizzazione complessa, il che rende l'inferenza ad alta velocità ancora più difficile da offrire.
I provider che competono solo sul prezzo taglieranno dove non puoi vedere: quantizzazione, batching, limitazioni. Quelli che competono sulle metriche che contano per il tuo workload costeranno di più, e varranno quanto costano.
Smetti di confrontare il prezzo per milione di token. Parti dai cinque fattori e trova i compromessi adatti al tuo workload.
Infercom pubblica benchmark in tempo reale su infercom.ai/performance, se vuoi confrontare queste metriche per conto tuo.
Fonti
Benchmark e prestazioni
- DeepInfra: DeepSeek V3.2 API Benchmarks
- MLCommons MLPerf Inference v5.0
- Artificial Analysis LLM Leaderboard
Architettura e calcolo
- Meta Engineering: Scaling LLM Inference
- Prefill Is Compute-Bound, Decode Is Memory-Bound
- NVIDIA: KV Cache Offloading
- Transformer FLOPs Analysis
Quantizzazione
- Red Hat: vLLM FP8 Benchmarks
- Red Hat: Half Million Evaluations on Quantized LLMs
- EMNLP 2025: INT4 Long-Context Degradation
- COLM 2025: Quantization Impact on Reasoning
Prezzi ed economia
Serving e batching
Scritto da Thomas Vits, con assistenza dell'AI.