Insights
Approfondimenti tecnici, analisi di settore e punti di vista sull'inferenza AI dal team di Infercom.
Il determinismo è l'obiettivo sbagliato: guida pratica a risultati LLM affidabili
Temperature, top_p, top_k e repetition_penalty spiegati: perché proprio temperature=0 mette a rischio la consistenza, perché la dimensione del batch cambia il tuo output e come ottenere risultati LLM affidabili.

Modelli AI open-weight: perché rappresentano un vantaggio strategico
I modelli open-weight come Gemma e MiniMax alimentano le tue applicazioni AI - e ti danno libertà che le API proprietarie non possono offrire. Cosa significa open weight, perché riduce il lock-in e come ti mantiene al controllo dei tuoi dati.
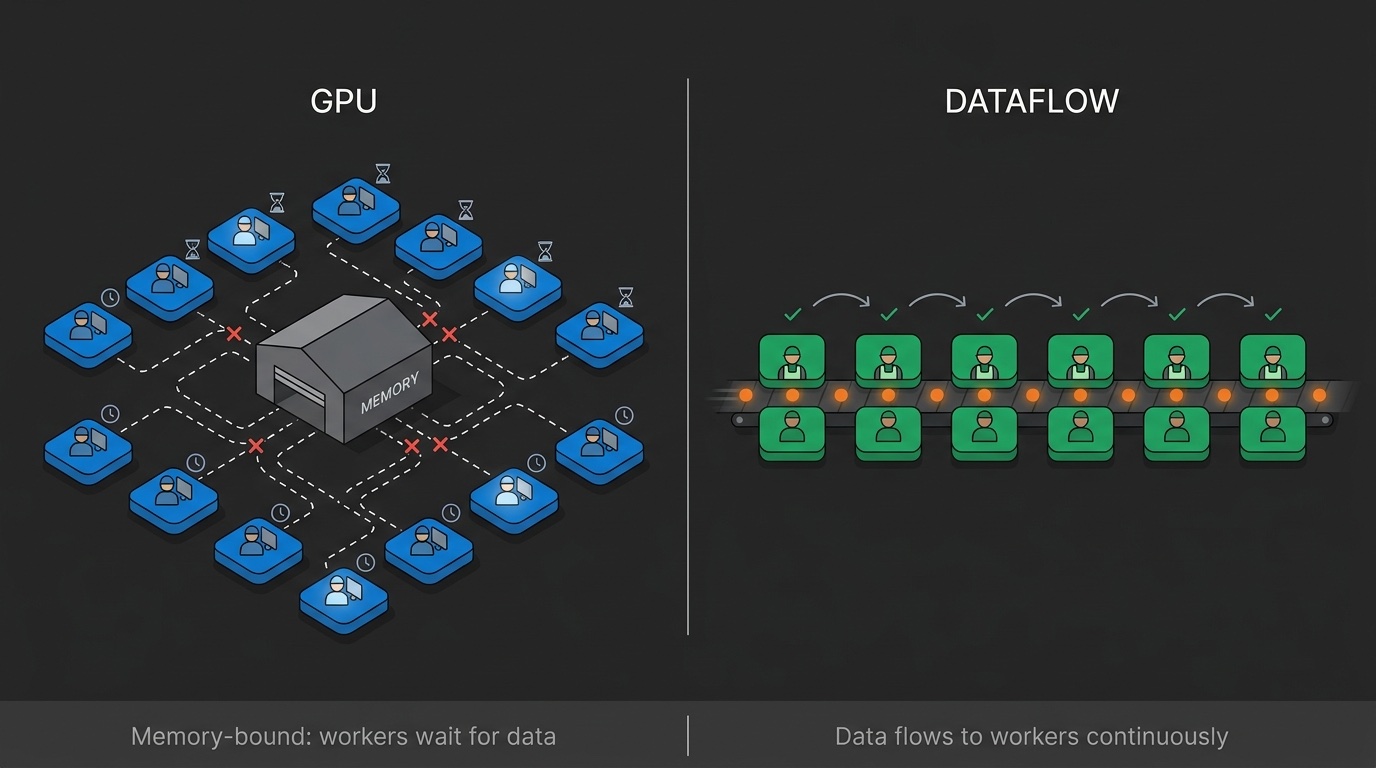
713 token al secondo: l'architettura dietro Ultraspeed
Perché l'architettura dataflow supera le GPU per l'inferenza LLM. Spiegazione tecnica dei colli di bottiglia della memoria, dell'esecuzione spaziale e del problema di decode.
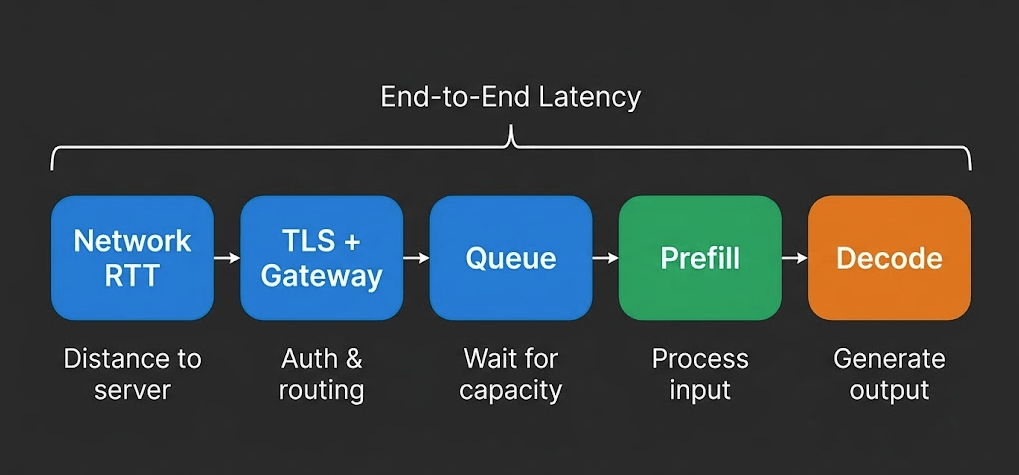
Velocità di inferenza LLM spiegata: TTFT, throughput e cosa conta davvero
Quando un provider pubblicizza 400 tok/s e un altro afferma latenza sotto 200ms, stanno misurando cose diverse. Scopri quali metriche contano per il tuo workload.
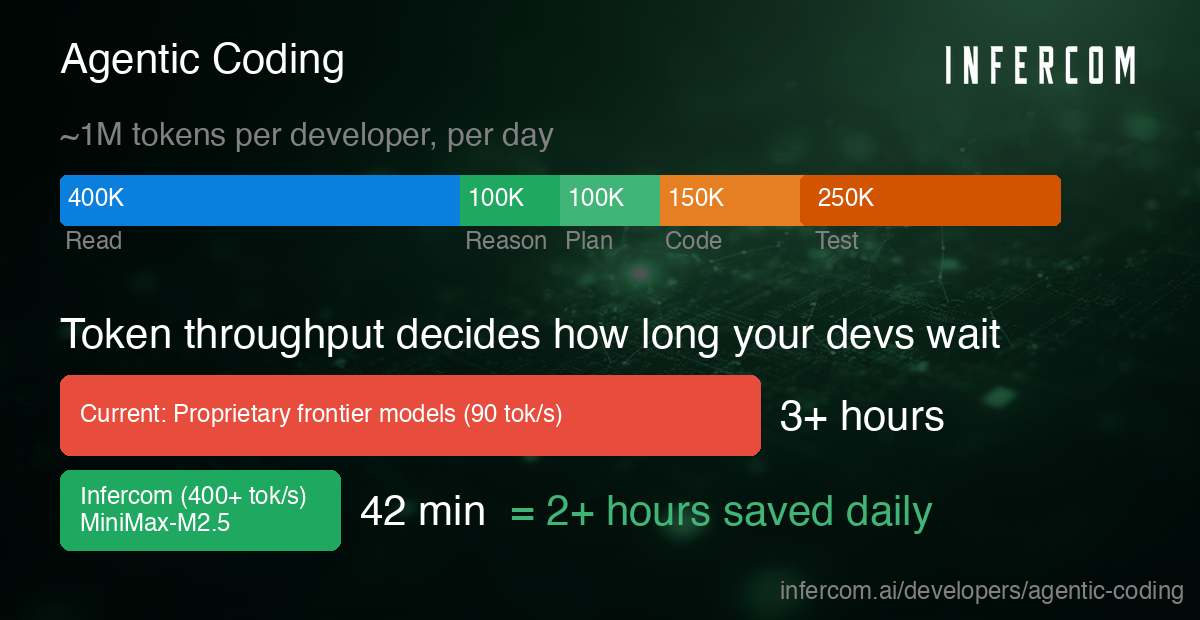
Velocità di inferenza nell'agentic coding: perché il throughput dei token è importante
Gli strumenti di agentic coding consumano 500K-2M token per sviluppatore al giorno. Questo articolo spiega perché la velocità di inferenza è importante e come configurare strumenti come Cursor, Cline e Codex CLI per un throughput più elevato.
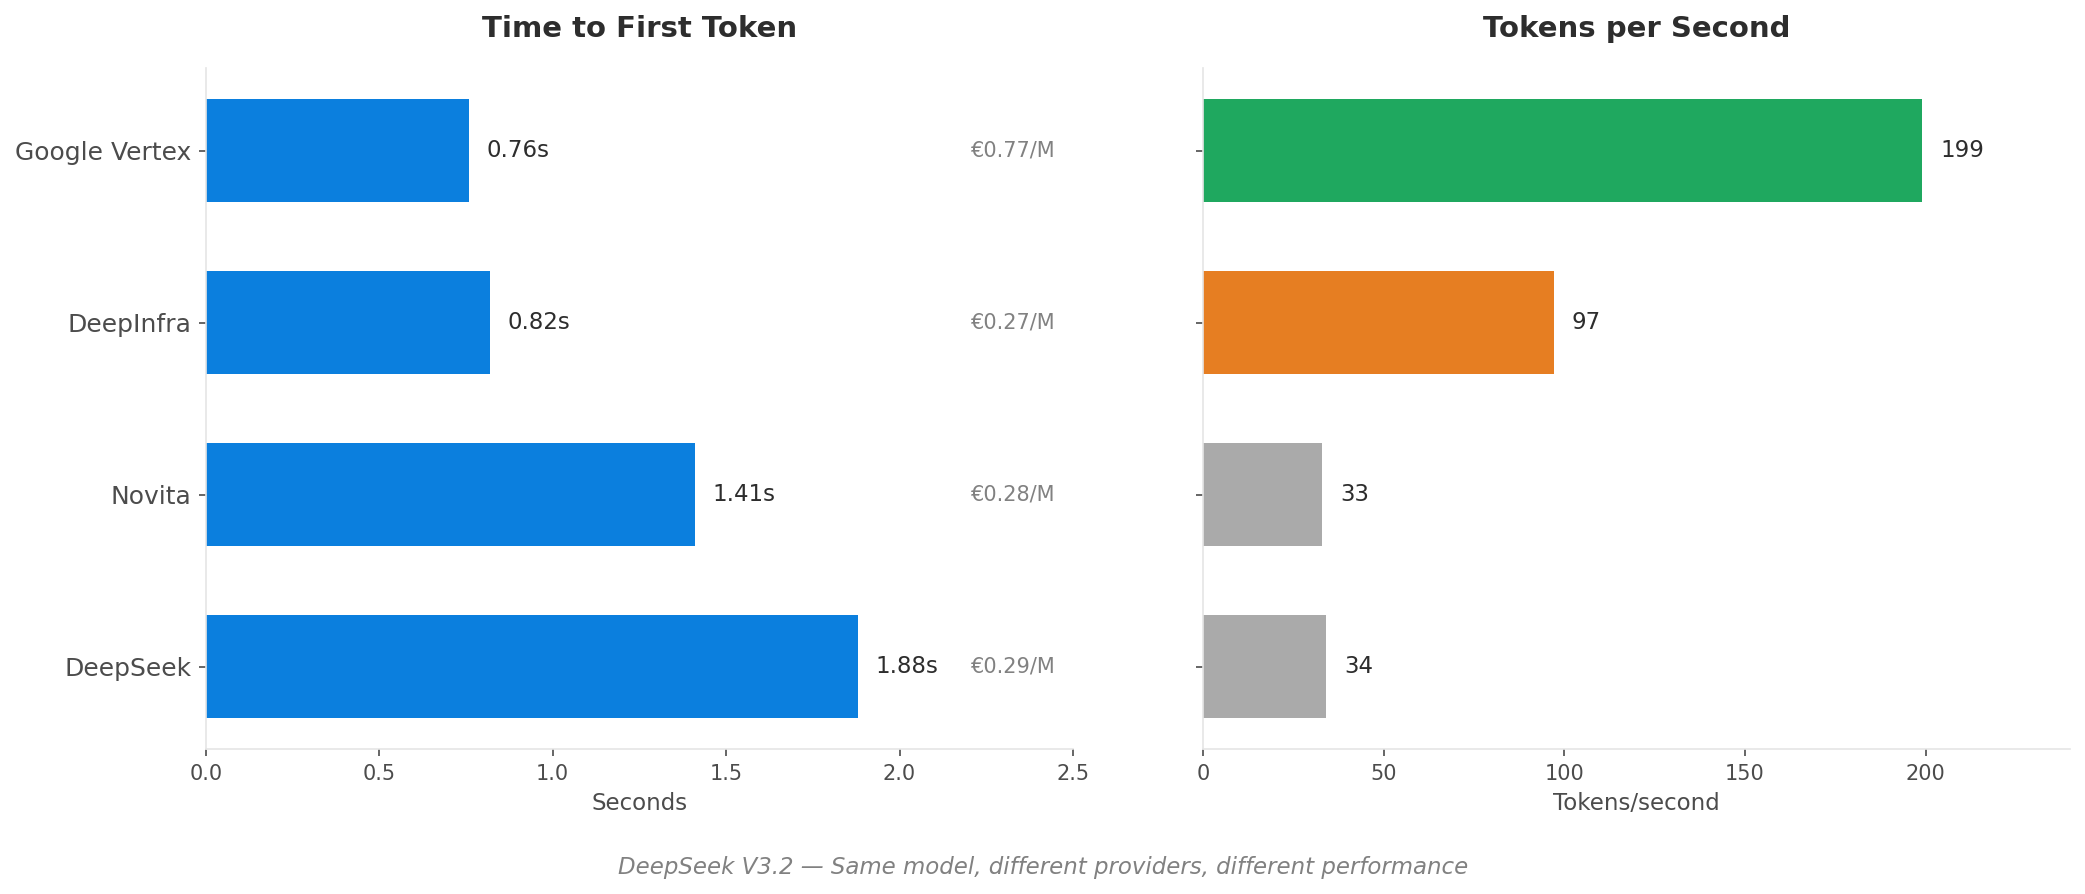
Cosa non ti dice il 'Prezzo per Token'
Se stai confrontando i fornitori di inferenza AI solo in base al prezzo per token, ti stai perdendo i fattori che determinano effettivamente costi e prestazioni.