Gli strumenti di agentic coding consumano molti più token delle classiche interfacce di chat. Per questo la velocità di inferenza incide direttamente sulla produttività degli sviluppatori.
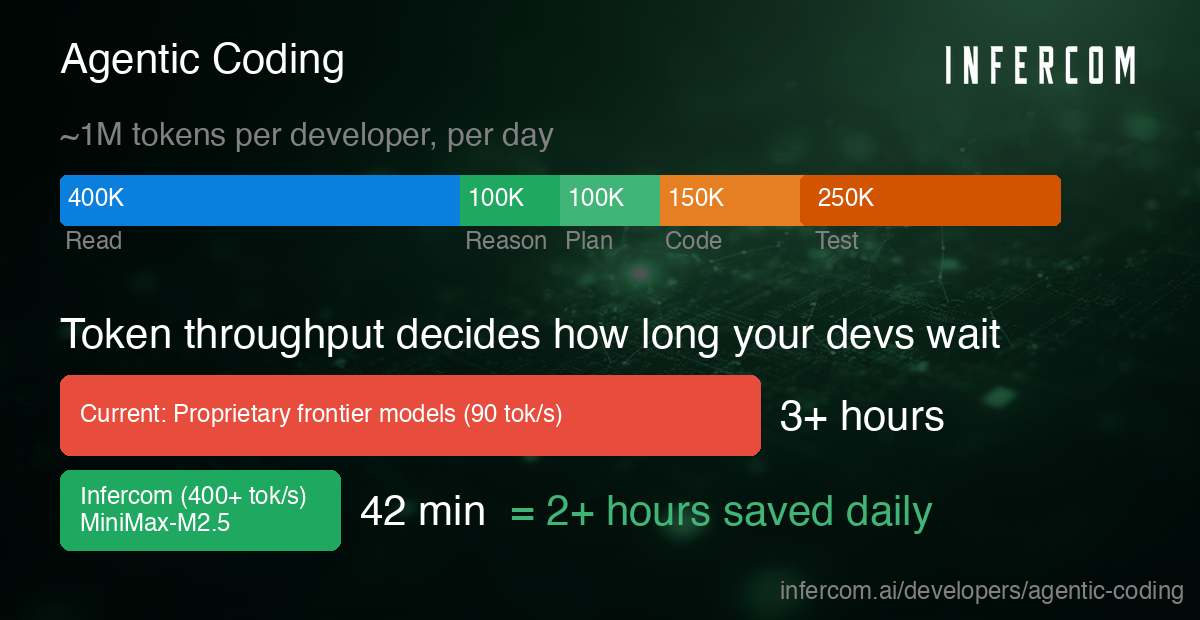
Chi usa Cursor, Cline o Codex CLI consuma di solito da 500K a 2M token al giorno. I workflow agentici richiedono moltissimi token: l'AI legge file, pianifica le modifiche, scrive codice, esegue test, incontra errori e riprova. Ogni passaggio richiede un round-trip verso l'API di inferenza.
Ecco come la velocità di inferenza incide sui tempi di attesa:
- A 90 token al secondo (tipico di un modello frontier): 1M token = ~3 ore di tempo di inferenza
- A 400+ token al secondo (MiniMax-M2.5): 1M token = ~42 minuti di tempo di inferenza
La differenza è notevole: un'inferenza più veloce significa meno tempo ad aspettare le risposte e più tempo in un flusso di lavoro produttivo.
Questo articolo spiega perché l'agentic coding ha requisiti di prestazioni diversi dagli strumenti AI basati su chat, e come ottimizzare per la velocità.
Perché gli strumenti di agentic coding consumano così tanti token
Negli strumenti AI basati su chat, un'interazione consiste di solito in un solo ciclo di richiesta e risposta.
L'agentic coding funziona in un altro modo. Un singolo task come "rifattorizza questo modulo" innesca decine di chiamate all'LLM. L'agente legge file, costruisce il contesto, pianifica come procedere, scrive codice, esegue test, incontra errori, fa debug e riprova. Ogni passaggio richiede un round-trip di inferenza.
Un singolo task si divide in due fasi distinte:
Fase di pianificazione (5-15 turni):
- Capire la struttura del codebase
- Analizzare dipendenze e architettura
- Progettare la strategia di migrazione
- Valutare rischi e casi limite
Fase di esecuzione (50-200+ turni):
- Leggere e analizzare file
- Scrivere diff e applicare le modifiche
- Eseguire i test e registrare i fallimenti
- Correggere gli errori e iterare finché tutto è verde
| Pattern | Turni | Token/sessione | Attesa (90 tok/s) | Attesa (400 tok/s) |
|---|---|---|---|---|
| Chat completion | 1-3 | 2-5K | secondi | secondi |
| Pipeline RAG | 3-5 | 10-30K | minuti | secondi |
| Agentic coding | 50-200+ | 500K-2M | ore | minuti |
Per dare un'idea di questi numeri: una semplice chat completion usa 2-5K token e si conclude in pochi secondi, qualunque sia la velocità di inferenza. Una pipeline RAG usa 10-30K token e richiede qualche minuto a bassa velocità, o solo pochi secondi con un throughput elevato. È con l'agentic coding che la velocità diventa decisiva: con 500K-2M token per sessione, la differenza tra 90 tok/s e 400+ tok/s vale ore invece di minuti di inferenza per ogni task.
La pianificazione trae vantaggio dall'intelligenza del modello, l'esecuzione dalla velocità. E l'esecuzione rappresenta di solito oltre il 90% dei token totali.
Consumo di token in una tipica sessione di agentic coding
Ecco come si ripartisce il consumo di token in un tipico task di agentic coding:
Scenario: rifattorizzare un modulo su 5 file, aggiungere test e correggere gli errori della CI
- Operazioni di lettura: ~50K token
- Pianificazione: ~20K token
- Generazione di codice: ~100K token
- Generazione di test: ~50K token
- Correzione errori (3 cicli): ~80K token
- Totale: ~300K token
A velocità diverse:
| Provider | Velocità | Tempo | Esperienza per lo sviluppatore |
|---|---|---|---|
| Modello frontier tipico | 60-100 tok/s | 50-83 min | Probabile cambio di contesto |
| MiniMax-M2.5 su Infercom | 400+ tok/s | 12 min | Si resta concentrati |
Per un task da 300K token, un tipico modello frontier a 60-100 tok/s richiede 50-83 minuti di inferenza. MiniMax-M2.5 su Infercom, a 400+ tok/s, completa lo stesso task in circa 12 minuti. Questa differenza di 4x o più decide se gli sviluppatori riescono a restare concentrati sul task o devono passare ad altro mentre aspettano.
Con 300K token per task, la differenza tra 12 e oltre 50 minuti di inferenza pesa molto sul lavoro degli sviluppatori.
La velocità di inferenza cambia il modo in cui gli sviluppatori lavorano con gli strumenti AI. Con risposte rapide possono iterare in cicli brevi. Con risposte lente tendono a passare ad altri compiti mentre aspettano, e anche questo ha un costo in produttività.
Due strade per un agentic coding più veloce
Ci sono due approcci principali per migliorare la velocità di inferenza negli strumenti di agentic coding:
Opzione A: sostituzione completa
Usi MiniMax-M2.5 per tutto. È la configurazione più semplice:
- Un modello, un provider
- 75,8% su SWE-bench Verified - al livello dei modelli frontier
- 400+ token al secondo su infrastruttura UE
- Configurazione più semplice, costo più basso
Ideale per: team che puntano su velocità e semplicità
Configurazione di Codex CLI (sostituzione completa):
# ~/.codex/config.toml
model = "MiniMax-M2.5"
model_provider = "infercom"

[model_providers.infercom]
name = "Infercom (EU Sovereign)"
base_url = "https://api.infercom.ai/v1"
env_key = "INFERCOM_API_KEY"
wire_api = "responses"
Opzione B: separare planner ed executor
Mantieni il tuo modello frontier (Claude, GPT, Gemini) per le decisioni di pianificazione complesse e affidi l'esecuzione a un'inferenza veloce.
Lo schema funziona così:
| Fase | Turni | Cosa succede | Priorità per il modello |
|---|---|---|---|
| Pianificazione | 5-15 | Capire il codebase, decisioni architetturali, strategia di migrazione, valutazione dei rischi | Qualità (modello frontier) |
| Esecuzione | 50-200+ | Lettura di file, diff, test, fallimenti, fix, iterazione | Velocità (modello veloce) |
Separare planner ed executor tiene conto del fatto che pianificazione ed esecuzione hanno requisiti diversi. La pianificazione comprende 5-15 turni in cui il modello analizza il codebase, prende decisioni architetturali e valuta i rischi: compiti in cui contano le capacità di ragionamento di un modello frontier. L'esecuzione comprende 50-200+ turni di operazioni sui file, generazione di codice, test e iterazione: compiti in cui conta soprattutto la velocità. Poiché l'esecuzione rappresenta la stragrande maggioranza dei token, affidarla a un modello veloce come MiniMax-M2.5 riduce molto il tempo totale di inferenza, mantenendo una pianificazione di qualità frontier.
Oltre il 90% dei tuoi token va all'esecuzione, non alla pianificazione. Affidali a un'inferenza veloce.
Ideale per: team che hanno già investito in un modello frontier e vogliono ottimizzare la maggior parte della loro spesa in token
Configurazione di Cline (planner ed executor separati):
Nelle impostazioni di Cline, attiva "Use different models for Plan and Act modes":
- Plan Model: Claude Sonnet (o il tuo modello frontier)
- Act Model: MiniMax-M2.5 tramite l'API di Infercom
Configurazione di OpenCode:
// opencode.json
{
  "agent": {
    "plan": {
      "model": "claude-sonnet-4-5-20250514",
      "provider": "anthropic"
    },
    "build": {
      "model": "MiniMax-M2.5",
      "provider": "infercom"
    }
  }
}
Configurare Codex CLI per Infercom
Codex CLI è l'assistente open source di OpenAI per l'agentic coding. Ecco come configurarlo per Infercom:
Prerequisiti:
- Node.js 18+
- Chiave API di Infercom (ottienila qui)
Installazione:
npm install -g @openai/codexImposta la tua chiave API:
export INFERCOM_API_KEY="your-key-here"
# Aggiungi a ~/.zshrc o ~/.bashrc per renderla permanente
Crea il file di configurazione (~/.codex/config.toml):
# Default settings
model = "MiniMax-M2.5"
model_provider = "infercom"
approval_mode = "suggest"  # Options: suggest, auto-edit, full-auto

# Infercom provider definition
[model_providers.infercom]
name = "Infercom (EU Sovereign)"
base_url = "https://api.infercom.ai/v1"
env_key = "INFERCOM_API_KEY"
wire_api = "responses"
Verifica la configurazione:
codex
# Dovrebbe mostrare:
# model: MiniMax-M2.5
# provider: infercom
Suggerimento: Codex CLI usa la Responses API (/v1/responses), non Chat Completions. Infercom supporta entrambe.
Come la velocità di inferenza influisce sul lavoro degli sviluppatori
Oltre al puro risparmio di tempo, la velocità di inferenza incide su diversi aspetti del lavoro di sviluppo.
Costo del cambio di contesto: Attese brevi (sotto i 30 secondi) permettono agli sviluppatori di restare concentrati sul task in corso. Attese più lunghe portano spesso a cambiare contesto, e tornare al task originale ha un costo di produttività a sé.
Frequenza delle iterazioni: Un'inferenza più veloce rende la sperimentazione più praticabile. Gli sviluppatori possono provare rapidamente più approcci e individuare i problemi prima nel ciclo di sviluppo.
Dimensione del ciclo di feedback: Risposte veloci permettono di lavorare per passi più piccoli. Le modifiche più piccole sono in genere più facili da rivedere, testare e integrare.
L'impatto sul team:
In un team di 5 persone in cui ogni sviluppatore risparmia 2 ore al giorno di attesa sull'inferenza, si arriva a 10 ore al giorno, cioè circa 200 ore al mese.
Con un costo pieno di €80 all'ora, sono €16.000 al mese di tempo di ingegneria che si può dedicare a lavoro produttivo.
L'impatto sulla produttività cresce con le dimensioni del team e con il volume di task di agentic coding.
Residenza dei dati nell'UE e conformità al GDPR
Per i team con requisiti di residenza dei dati, la posizione dell'infrastruttura di inferenza conta.
Per MiniMax-M2.5 su Infercom valgono questi punti:
- Hardware SambaNova a Monaco, Germania
- Piena conformità al GDPR
- Nessuna esposizione al CLOUD Act statunitense
- Infrastruttura certificata ISO 27001
Per i team di settori regolamentati (finanza, sanità, legale, pubblica amministrazione), la residenza dei dati nell'UE può essere un requisito di conformità.
Prestazioni e sovranità:
Storicamente l'inferenza ospitata nell'UE è stata associata a prestazioni inferiori rispetto ai provider statunitensi.
MiniMax-M2.5 su Infercom dimostra che un throughput elevato (400+ tok/s) è raggiungibile su infrastruttura UE. Cade così il tradizionale compromesso tra sovranità dei dati e velocità di inferenza.
Per iniziare
Per provare Infercom con i tuoi strumenti di agentic coding:
- Ottieni una chiave API - su cloud.infercom.ai/apis
- Configura il tuo strumento - Infercom supporta Codex CLI, Cline, Cursor e altri strumenti compatibili con OpenAI
- Prova con un task reale - usa un vero task di sviluppo per valutare la differenza di prestazioni
Per istruzioni dettagliate su ogni strumento, consulta la nostra documentazione sull'agentic coding.
La configurazione richiede di solito pochi minuti.
Verifica dell'API:
curl -s https://api.infercom.ai/v1/responses \
  -H "Authorization: Bearer $INFERCOM_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"MiniMax-M2.5","input":"Write a Python function to reverse a string"}' \
  | jq '.output[0].content[0].text'
Riepilogo
Gli strumenti di agentic coding hanno requisiti di prestazioni radicalmente diversi dalle interfacce AI basate su chat, a causa del loro elevato consumo di token.
La velocità di inferenza incide direttamente sulla produttività degli sviluppatori, grazie ad attese più brevi e cicli di feedback più stretti.
MiniMax-M2.5 su Infercom offre un throughput di 400+ tok/s, un'accuratezza del 75,8% su SWE-bench, una finestra di contesto da 160K e la residenza dei dati nell'UE.
Per i team che valutano provider di inferenza per workload di agentic coding, il throughput dovrebbe essere un criterio primario, insieme alla qualità del modello e ai requisiti di residenza dei dati.
Scritto da Thomas Vits, con assistenza dell'AI.